- 半導体事業HOME
- マクニカの製品・サービス
-
技術情報

-
イベント・セミナー
- 取扱メーカー
- サポート
- お問い合わせ
- 製品購入はこちら
- 半導体事業のメルマガ登録
はじめに
2026年9月5日~6日の2日間にわたり、有明GYM-EXを舞台に、DIYとテクノロジーの祭典「Maker Faire Tokyo 2026」が開催されました。
日本最大級のDIY展示イベントである会場には、個人クリエイターから企業、学生にいたるまで、多種多様な「メイカー(作り手)」が集結。最新テクノロジーを活用したロボットや電子工作、体験型プロダクトなど多彩な作品が並ぶ会場に、ファミリー層をはじめとした多くの来場者が足を運び、イベントを楽しみました。
そんななか、マクニカは最新のArduino基板を活用したエッジAIの体験ブースを出展。クラウドを介さずデバイス上でリアルタイムに画像認識や推論をおこなうデモを通じ、手軽に高度なエッジAI開発に挑戦できる、新たなプロトタイピングの可能性を提示しました。
本レポートでは、会場で実施した各デモの様子などをご紹介します。
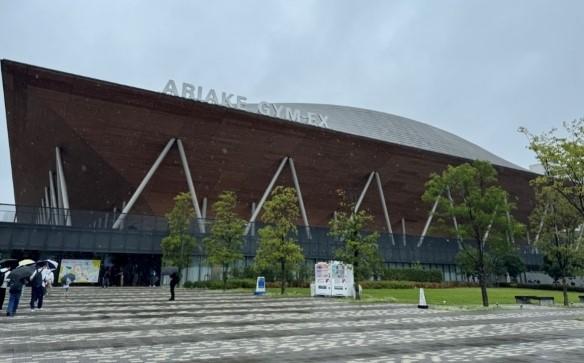
▲会場となった、有明GYM-EX
※本イベントにおける「VENTUNO Q(国内未発売ボード)」の展示デモは、国内電波法に基づく「電波利用制度の特例(実験等無線局の特例制度)」の申請を行った上で、限定条件のもと実施いたしました。現在、電波法の認証取得を進めており、国内販売開始後はMacnica-Mouser(マクニカ マウザー)にて購入可能となる予定です。販売開始時期については、本サイトおよびメールマガジンにてご案内いたします。
出展テーマ:ハード開発の手間を省き、エッジAI検証を高速化
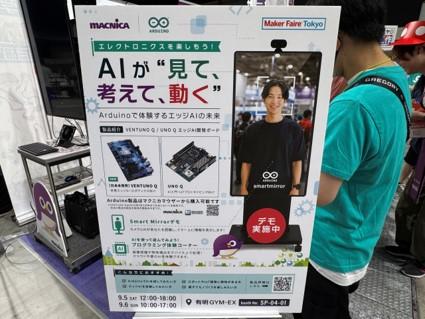
今回のマクニカブースでは、「エレクトロニクスを楽しもう! AIが“見て、考えて、動く” Arduinoで体験するエッジAIの未来」をテーマに出展しました。
これまでのエッジAI開発において最大の壁となっていたのが、ハードウェア準備の手間とコストです。
カメラ画像や音声を用いたリアルタイム処理、あるいは精密なモーター制御などを実現しようとすると、これまでは専用の基板を一から設計・開発する必要があり、アイデアを思いついてからプロトタイプで検証するまでに膨大な時間とリソースを要していました。
そうした開発現場の課題に対し、マクニカが提案するのが「最新のボードコンピューターを活用した、即座に試せる開発環境」です。
ブースで紹介された「UNO Q」や「VENTUNO Q」といったボードは、画像認識やAI推論を担う高度なMPU (Micro Processing Unit)と、モーター制御やセンサー処理をリアルタイムで司るMCU (Micro Controller Unit)を1枚の基板上に統合したデュアル構成を採用しています。
これにより、開発者はゼロから複雑な基板を設計することなく、既成のボードを使って「自分のやりたい処理やサンプル動作が実現可能か」を即座に実験・検証できるようになります。
ハードウェア開発のハードルを大幅に下げ、アイデアから実証までのスピードを飛躍的に高めること、それこそが今回のマクニカ出展における最大の訴求ポイントです。
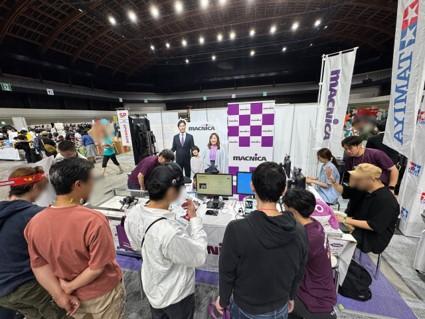
▲ブースの様子。
AIを使ったデモを体験してみたいと、大勢の方が訪れてくださいました。
実施デモ紹介
ここからは、3種類の展示デモそれぞれの内容をご紹介します。
登録からリアルタイム認識までをその場で体感!追従体験&VLM高速処理デモ
体験の流れと仕組み
1つめのデモは、モニターの上に設置されたカメラでヒトの顔や手の動きを即座に認識・登録し、直感的な画面操作やデバイス制御をおこなうというもの。
こちらでは、細かく分けて「キャラとあそぶ」「AIにおしえる」「光で描く」の3つを体験できました。
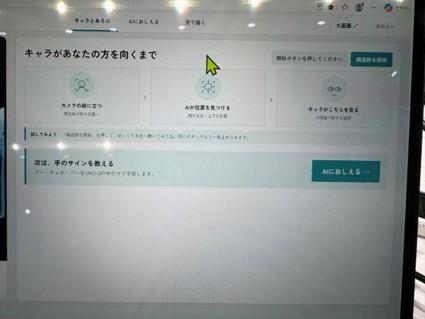
▲最初に表示されていたこの画面から、さまざまなデモを開始。
まず「キャラとあそぶ」では、モニター上部のカメラに自分の顔を検知させます。
そのあとに自分が顔を動かすと、モニターの中にいる女の子の視線や顔の向きが、その動きをリアルタイムで追従してくれるようになりました。
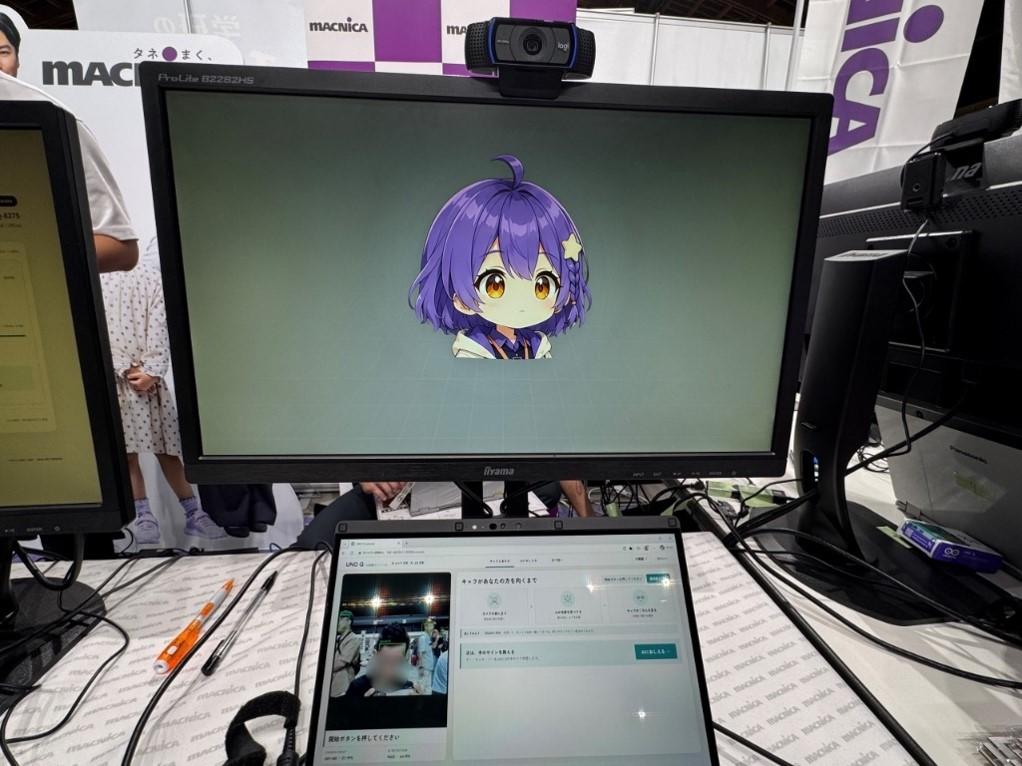
▲初期状態。
画面の女の子は左(向かって右)を向いていますが、モニター上のカメラに自分の顔を認識させて、そのあとに自分が顔を動かすと……。
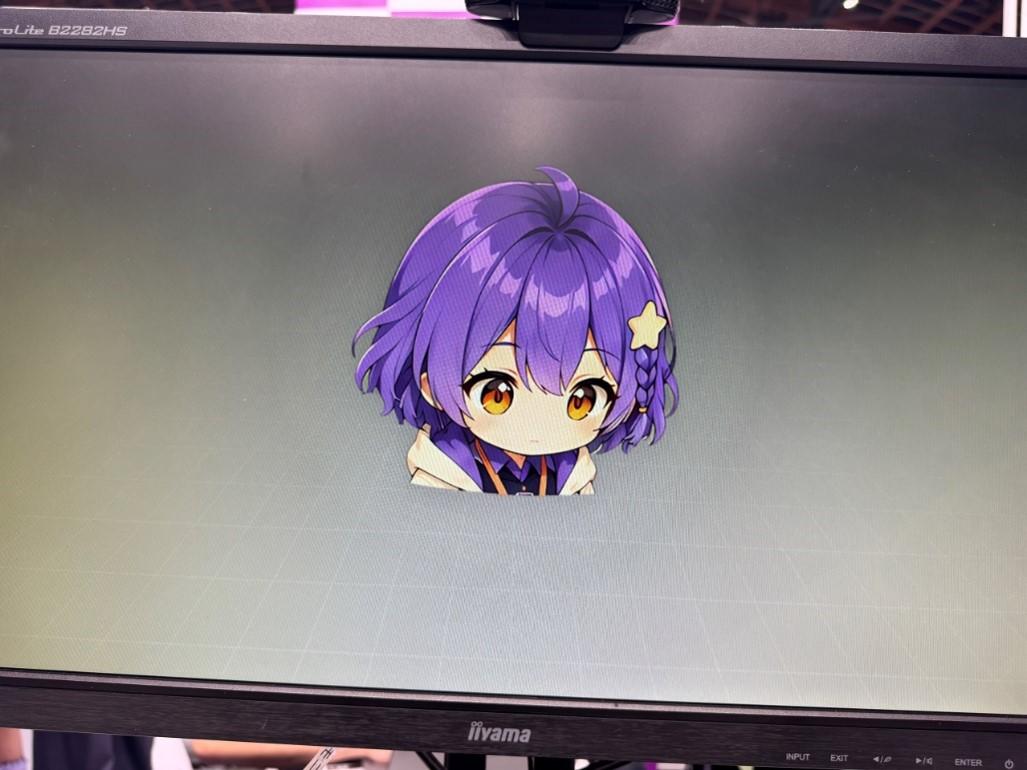
▲女の子の顔も、同じ方向を向きました。
次の「AIにおしえる」では、「ハンドサインの即時登録」で遊べました。
自分の手をカメラに向かって手をかざすと、AIが手の骨格を3次元(X・ Y・ Z軸)で立体的に捕捉し、少量の画像を撮影するだけで特徴を覚えさせることができるという内容で、今回は グー・チョキ・パーの3つをサンプルとして登録。
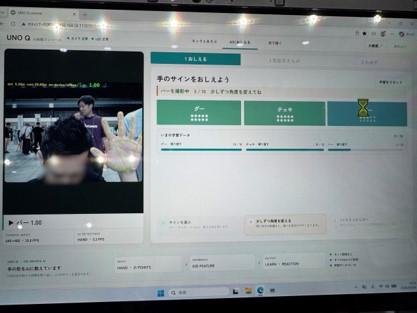
▲このように、カメラに向かってハンドサインを出して登録します。かかった時間は、1工程あたり10秒くらいでした。
そして登録完了後は、実際にハンドサインを使った出力デモを実施。たとえば「グーを出したら背景を赤色にしてキラキラのエフェクトを出す」「チョキを出したら青色にしてハートを出す」などの反応を任意に設定でき、手をかざすだけで画面演出を切り替えられました。
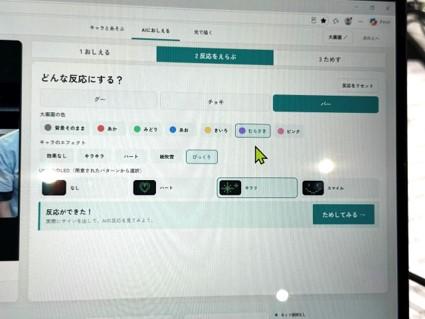
▲このあと自分がグー・チョキ・パーを出したときに、画面の表示をどのように出力するかを設定する画面。
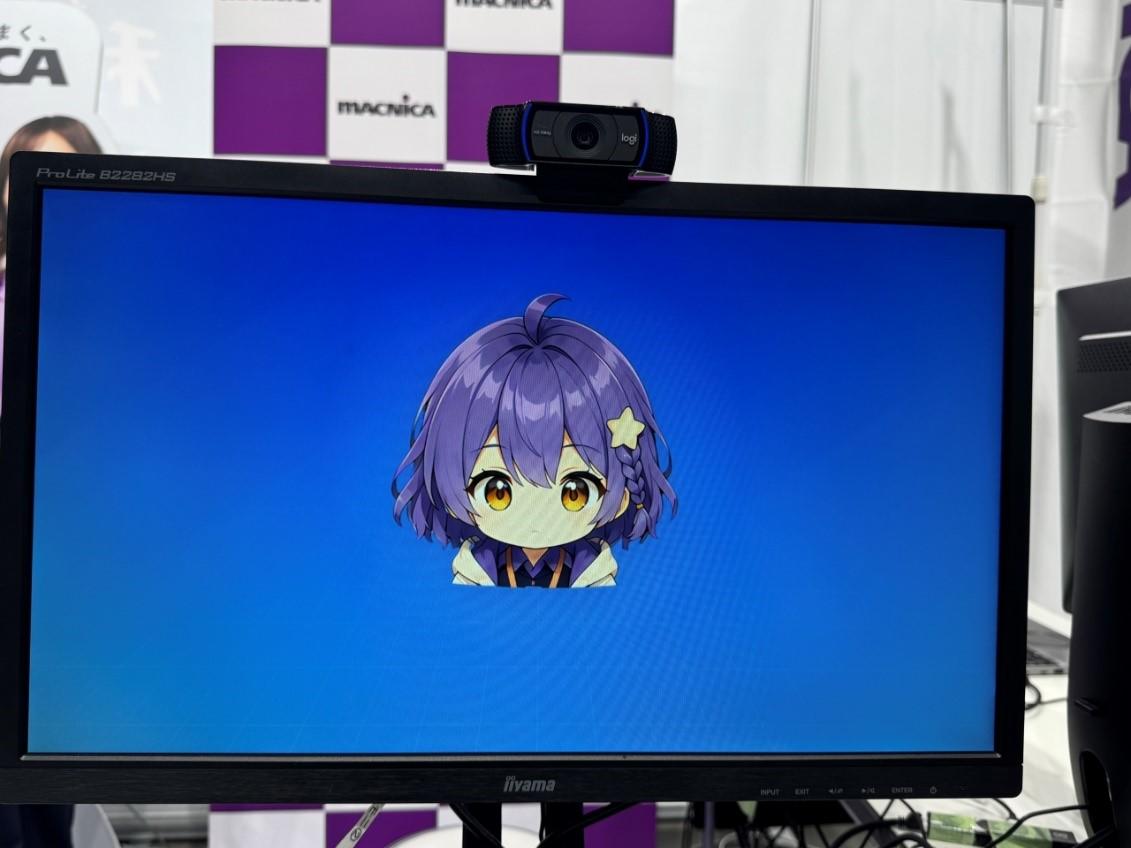
▲たとえば、グーを出すと背景が青くなって……。
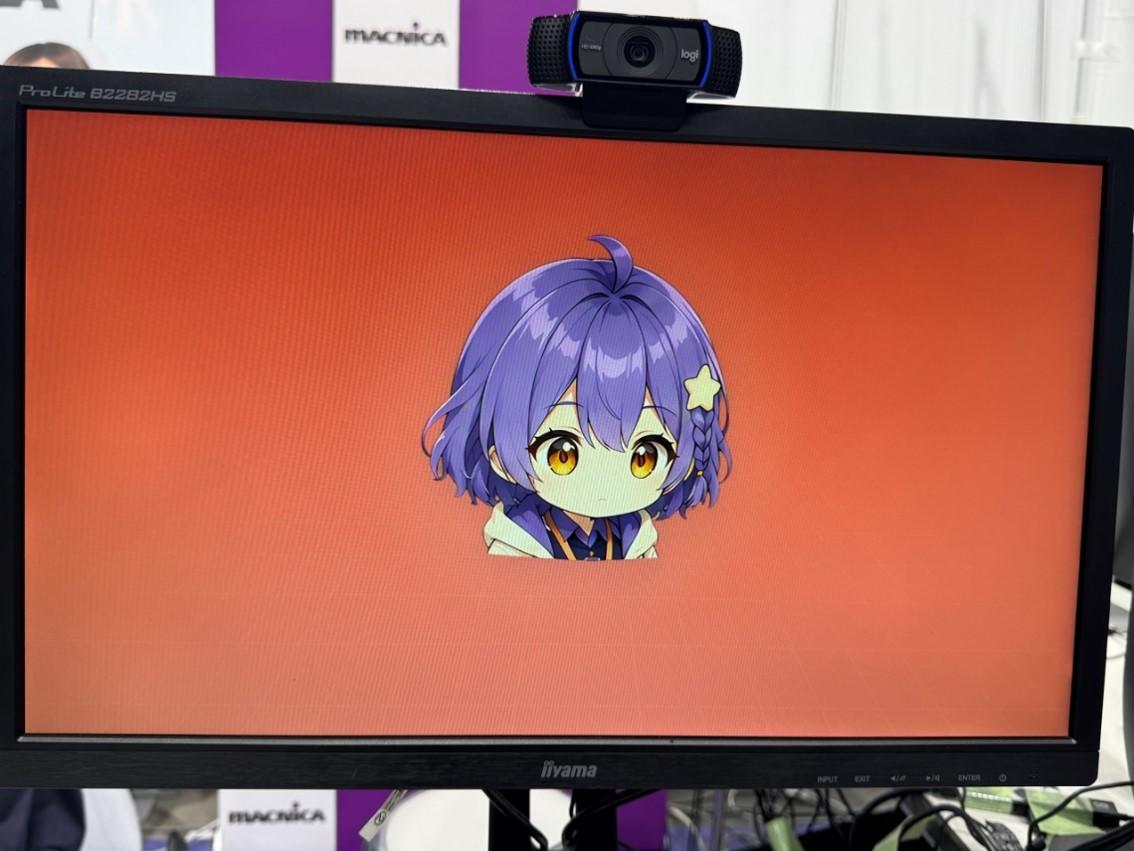
▲チョキを出すと赤くなる、といった具合です。
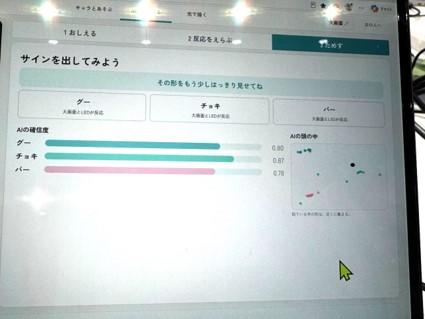
▲AIの「確信度(カメラに写ったハンドサインの形に対して、どのくらいの確信をもっているかの数値)」を見ることもできました。
薬指と小指を曲げた、よく分からないサインを出したら混乱するかも?
最後の「光で描く」は、先ほど登録した手の情報を使っておこなう遊び。具体的には、登録した「パー」の手を動かすと、その軌道に合わせて画面上のマス目と、基板上のLEDマトリクスが連動して点灯するというものでした。いわば、空中に絵を描くような直感的な操作の体験です。
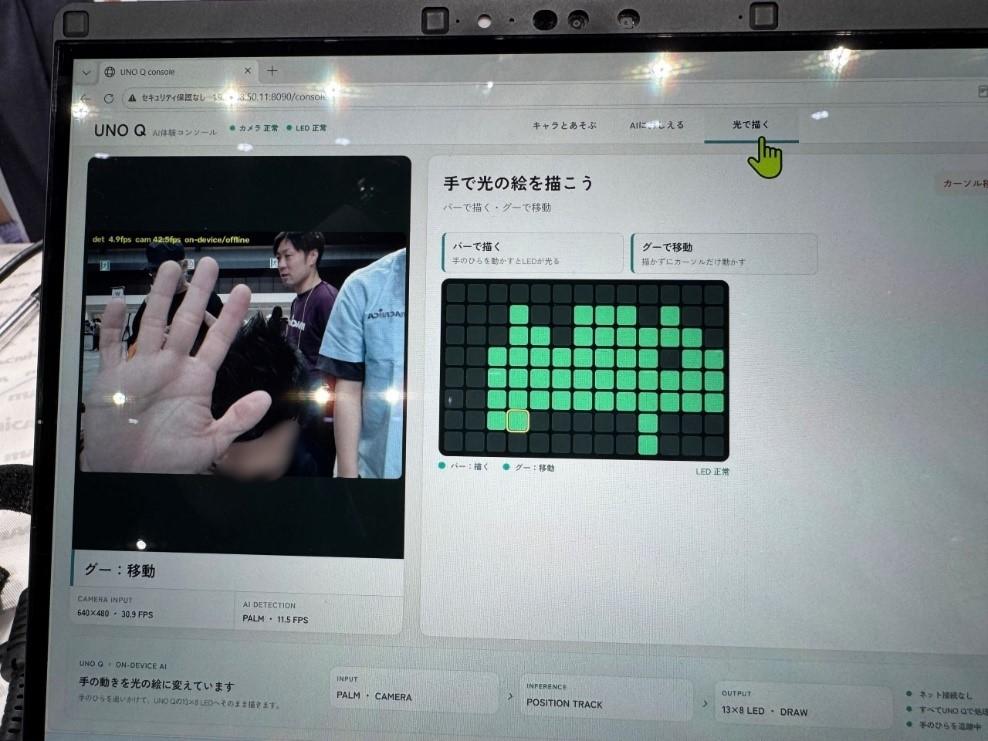
▲手を動かすと、黒いマスが緑色に変わって絵を描けます。
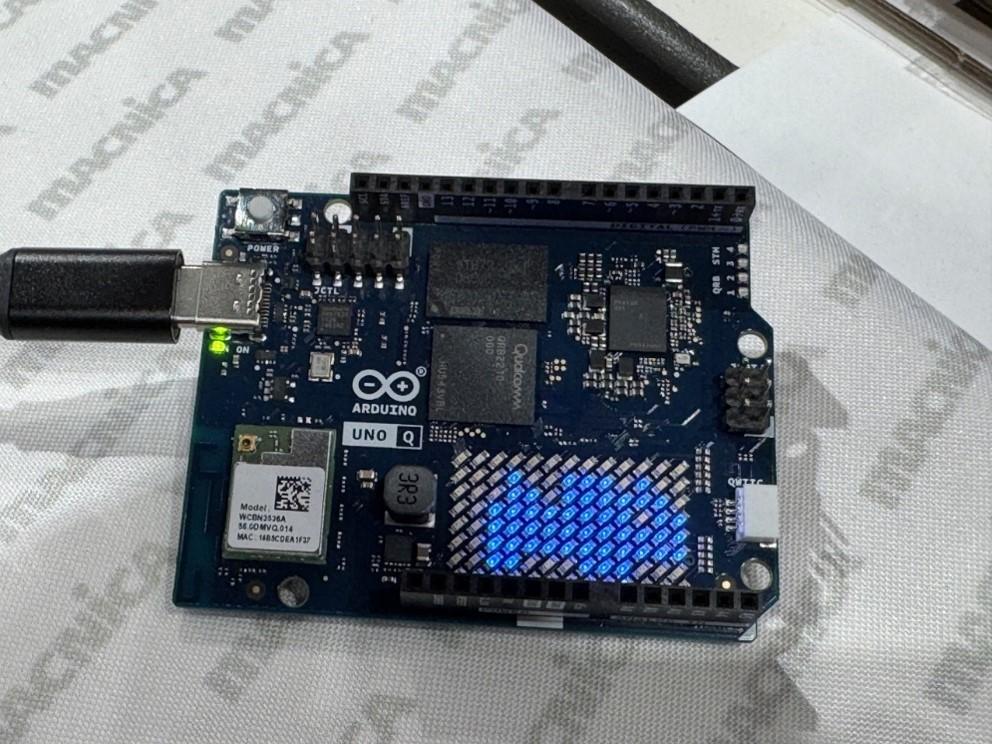
▲それに連動して点灯していた、「UNO Q」基板のLED。
いっぽう、同じテーブルで展開されていたVLM処理デモでは、カメラで捉えた画像情報をAIが解析し、状況を説明する文章を生成する高度な処理を実施。具体的には、同じVLM処理を「CPUのみ」で実行した場合と、「NPU(AI専用プロセッサー)」で実行した場合の比較展示していました。
CPU処理では画像認識と文章生成までに10秒近くかかっていたところ、NPUを活用した環境では3秒以下へと劇的に処理時間が短縮される様子が、目の前で示されました。
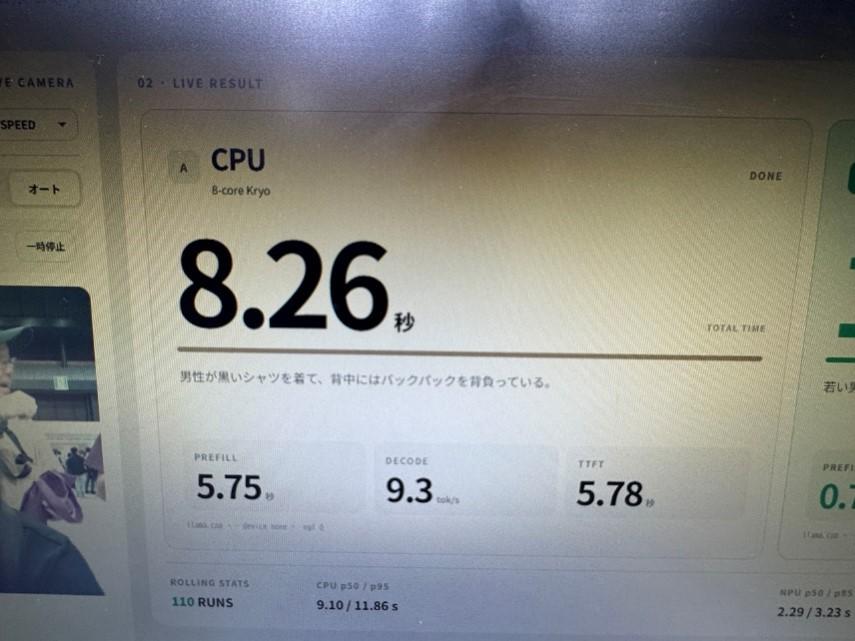
▲カメラが認識した様子が、自動的にテキストで出力されます。画面に表示されているのは、CPUのみでそれを処理した場合。
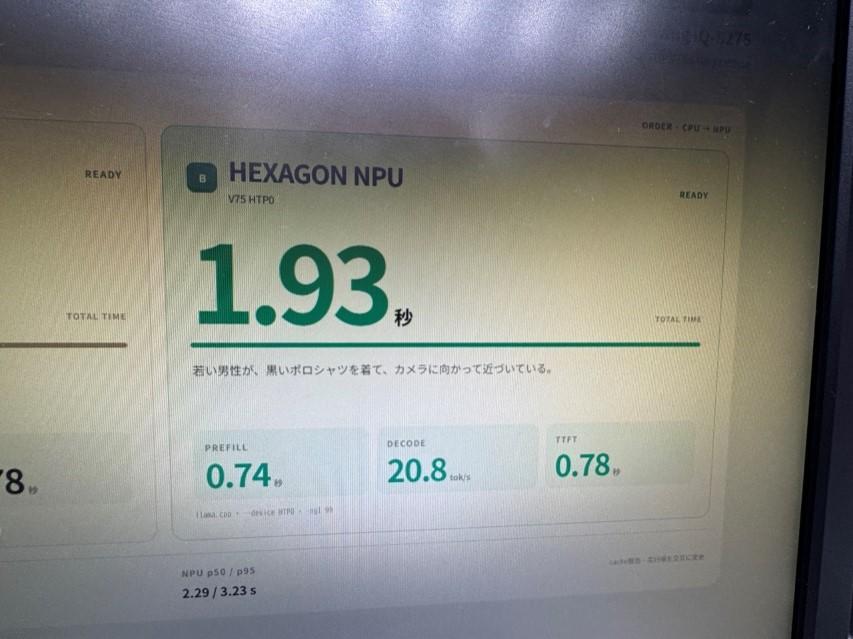
▲NPUは、CPUよりも4倍くらい速く処理をおこなっていました。
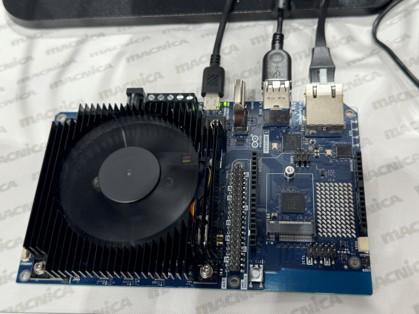
▲VLM処理デモで使われていた、「VENTUNO Q」の基板。
技術的なポイントと今後の可能性
本デモの最大の特長は、クラウドを介すことなく、すべて基板上のデバイス(エッジ)側でリアルタイム処理を完結させている点にあります。
「UNO Q」においては、Qualcomm製SoC (CPU)上で顔検出から3次元骨格推定、AI推論、画面描画、LED制御に至る一連の処理を直接実行。キーボードやタッチパネルなどの物理デバイスに触れない非接触UIやジェスチャー制御を実現できるため、衛生面が重視される医療・調理現場での機器操作やスマート家電の新しい操作系、アミューズメント機器への展開が期待されます。
いっぽう、「VENTUNO Q」ではNPU(AI専用プロセッサー)の強力な処理能力を活かすことで、従来はクラウド依存や遅延が課題であったVLM(ビジョン言語モデル[HI13.1])処理を劇的に高速化させました。
カメラ映像から周囲の状況を瞬時に判断してテキスト化・音声可視化するスマートカメラや、現場の状況に応じて自律的に状況を判断する高度な産業用エッジ機器など、より複雑なリアルタイムAIソリューションへの応用可能性を示しています。
②四足歩行ロボット
概要と動作の仕組み
2つめのデモは、エッジAIとリアルタイム制御の融合です。
こちらでは、PCやスマートフォンから遠隔で操作・制御できる四足歩行ロボット(ロボット犬)の筐体を使用。ロボットの背中には小型かつ高性能な「UNO Q」基板が直接設置されており、フロントカメラで周囲の映像を捉えながら、リアルタイムでAIによる物体検出プログラムを実行しています。
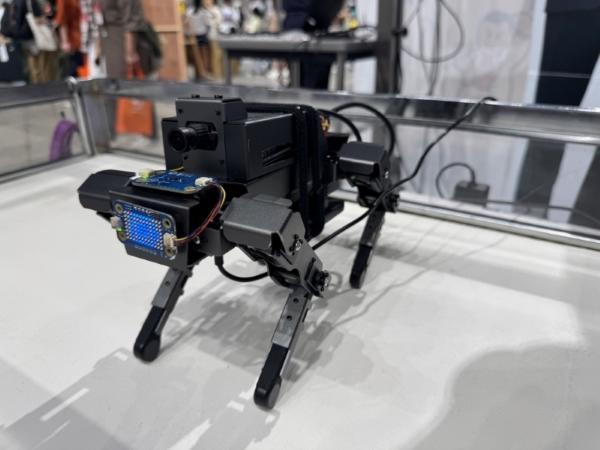
▲基板を搭載した4足歩行ロボット。
基板上の構成としては、カメラ映像の解析やビジョン処理といった高度な情報処理をMPUが担い、歩行や姿勢保持に必要な複数モーターの緻密なリアルタイム制御をMCUが担当する、デュアル構造を活かしています。
今回は「既成のロボット筐体とUNO Qを組み合わせることで、高度な基板を一から開発することなく、即座にAIロボティクスのプロトタイピング環境を構築できること」を直感的に示す展示として展開されました。
技術的なポイントと今後の可能性
現段階ではカメラで捉えた物体検出結果を即座に歩行動作へフィードバックする実装までは行っておらず、ランダム走行や遠隔操作と並行してエッジAIが認識処理を行っている状態ですが、AIの認識結果と動作制御を連動させれば、多様な発展が期待できます。
たとえば、特定の色のボールを認識して追従・停止するハンドサイン制御や、人間が「待て」と手をかざすだけでその場に停止する非接触操作などの実装が可能です。
さらに筐体の性能を高めれば、災害現場で障害物を回避しながら自律歩行し、倒れている要救助者をカメラ映像から識別して自動で外部連絡を入れることなども可能。このように、産業・防災分野向け自律型ロボットへの応用も想定されています。
③スマートミラー
3つめのデモは、「VENTUNO Q」を搭載し、視覚言語モデル (VLM)を活用したサイネージ型コンセプトのものでした。
本デモは、大型ディスプレイにカメラと「VENTUNO Q」基板を組み込んだ、一見すると姿見(ミラー)のようなスタイリッシュな筐体で展示されていました。
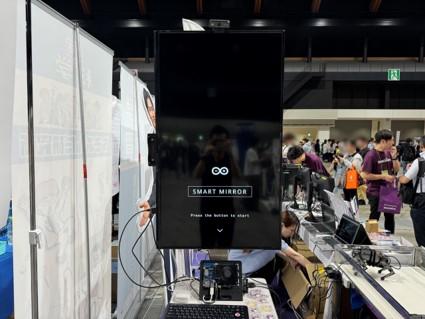
まず、ヒトが機械の前に立つと、上部に設置されたカメラが人物の全身像を撮影。次に基板上で動作するAI (VLM)が映し出された人物のファッションや着こなし・色合い・服装の特徴(「ライトグリーンのパーカーを着用」「ダークトーンのパンツ」など)を瞬時に認識・解析します。
そしてそのあと、AIが一人ひとりの服装に合わせたコメントやスタイリングのアドバイス文をリアルタイムで生成し、その内容がミラー上の画面に表示される仕組みでした(本来は音声読み上げ機能も搭載できるが、本イベントでは未実装)。
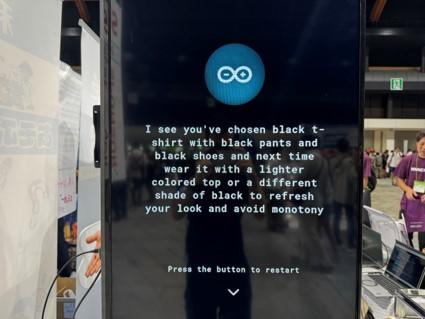
▲筆者の場合。「黒のTシャツに黒のパンツ、黒の靴を合わせていますね。次回は明るい色のトップスを合わせるか、色味の異なる黒を取り入れてみると、単調にならず気分もガラッと変わりますよ。」と書かれています。ど、どうもありがとう(?)。
こちらのデモは、「AIは自分(人)の姿をどのように認識し、解釈しているのか?」という好奇心を刺激しながら、最新のエッジAI技術を楽しめるとして、注目を集めました。
技術的なポイントと応用可能性
このデモの最大の技術的特長は、通常であれば高度なクラウドサーバーや大型PCを必要とする「画像解析(VLM)→ テキスト生成 → 音声合成 (TTS)」という重い処理フローを、すべて小型な「VENTUNO Q」基板単体(エッジ側)で完結させている点です。
「VENTUNO Q」に内蔵された強力なNPU(AI専用プロセッサー)を活用することで、カメラ映像を入力してからのタイムラグを大幅に低減。通信環境に依存せず、個人情報となる映像データを外部サーバーに送信することもないため、プライバシーに配慮したリアルタイムAI処理を実現しています。
この仕組みは、アパレル店舗や商業施設におけるインタラクティブなデジタルサイネージとして非常に高い応用可能性を秘めています。
来店客の服装に合わせたおすすめ商品のリアルタイム提案やECサイトへの誘導、美容院・サロンでのスタイリングシミュレーション、あるいは無人店舗(スマートショップ)での接客アシスタントなど、実店舗における顧客体験 (CX)をアップデートする新たな店舗ソリューションへの展開も期待されます。
おわりに
今回の「Maker Faire Tokyo 2026」におけるマクニカブースの展示は、これまでハードウェア開発やAI実装の大きな障壁となっていた「複雑な基板設計」や「高度なAI処理環境の構築」という課題に対し、明確なソリューションを提示する機会となりました。
カメラ映像をリアルタイムに解析する高度なビジョンAIや、大容量データを扱うVLM、さらには精密なモーター制御を伴うロボティクス開発……。従来であれば、専用のカスタム基板を一から設計・製造しなければ実現できなかったこうしたシステムが、「UNO Q」や「VENTUNO Q」といったコンパクトな基板1枚で即座に検証できる時代が到来しています。
クラウドを介さずデバイス上で処理を完結できるエッジAIの手軽さと、NPUによる圧倒的な処理スピードが組み合わさることで、エンジニアは「まずは動くプロトタイプを作り、アイデアの価値を現場で素早く検証する」というアジリティの高い開発サイクルを回すことが可能になります。
また、エッジAIの可能性は、スマート家電やアパレル・商業店舗向けのサイネージ、産業用ロボット、防災・医療ソリューションなど、アイデア次第でどこまでも広がります。
マクニカでは今後も、こうした最先端のボードコンピュータの提供と充実した技術サポートを通じて、エンジニアやクリエイターの皆様が「つくる」挑戦を強力にバックアップしてまいります。
Arduino製品購入はこちら
評価、試作用途、少量の部品購入につきましては、
最新製品を1個から購入できるMacnica-Mouser をご利用ください。
本記事のチラシ
お問い合わせ
本記事の内容に関するご質問や、製品詳細情報をご希望の方はこちらからお問い合わせください。