- 半導体事業HOME
- マクニカの製品・サービス
-
技術情報

-
イベント・セミナー
- 取扱メーカー
- サポート
- お問い合わせ
- 製品購入はこちら
- 半導体事業のメルマガ登録


 条件を指定して絞り込む
現在2259件がヒットしています。check
第2話の内容
第1話では、ハイブリッド推論環境の構成と、日常業務をオープンウェイトのLLMでどこまで賄えるのかを、私の実業務での検証結果とともに紹介しました。411リクエストのうち402件(約98%)がオンプレミスで完結し、フロンティアモデルへのエスカレーションは9件にとどまりました。
本話で扱うのは、残る2つの疑問、性能とコストです。まず、GPUサーバ1台で何人分のエージェントを支えられるのかを、公開ベンチマークで定量的に測定します。そのうえで、初期投資1億円の環境が何名の利用で元を取れるのかを、実運用データから試算します。
性能測定:NVIDIA DGX™ B200 1台は何人まで支えられるのか?
利用者が今後増えたとき、このサーバが何名の利用まで応答速度を維持できるのかというのが、気になるのではないでしょうか。ただし、性能を自前のテストで計測すると、条件の設定次第で結果が大きく変わります。プロンプトを短くする、同じ文章を繰り返し送ってキャッシュに当てる、モデルの出力が早く終わるのを許容する、といった条件で測れば、数字はいくらでも良くなります。こうした計測結果は、読者にとって判断材料になりません。
エージェントの利用は、長いプロンプトの連続であり、チャット向けのベンチマークとは負荷の性質が異なります。そこで今回は、実際のエージェントのセッションを再生する、SemiAnalysisが公開しているベンチマーク「AgentX MVP」[1][2] を使用しました。
AgentX MVPは、実際のClaude Codeのセッション393本を、記録された順序と間隔のまま再生するベンチマークです。「出力を途中で打ち切らない」「記録された間隔を守る」「キャッシュの効果を水増ししない」といったルールはツール側で固定されており、計測する側が後から条件を変えることはできません。結果には、ルールに従った計測かどうかを示す判定(submission_valid)が付きます。
計測方法:実際のClaude Codeセッションを再生して測る
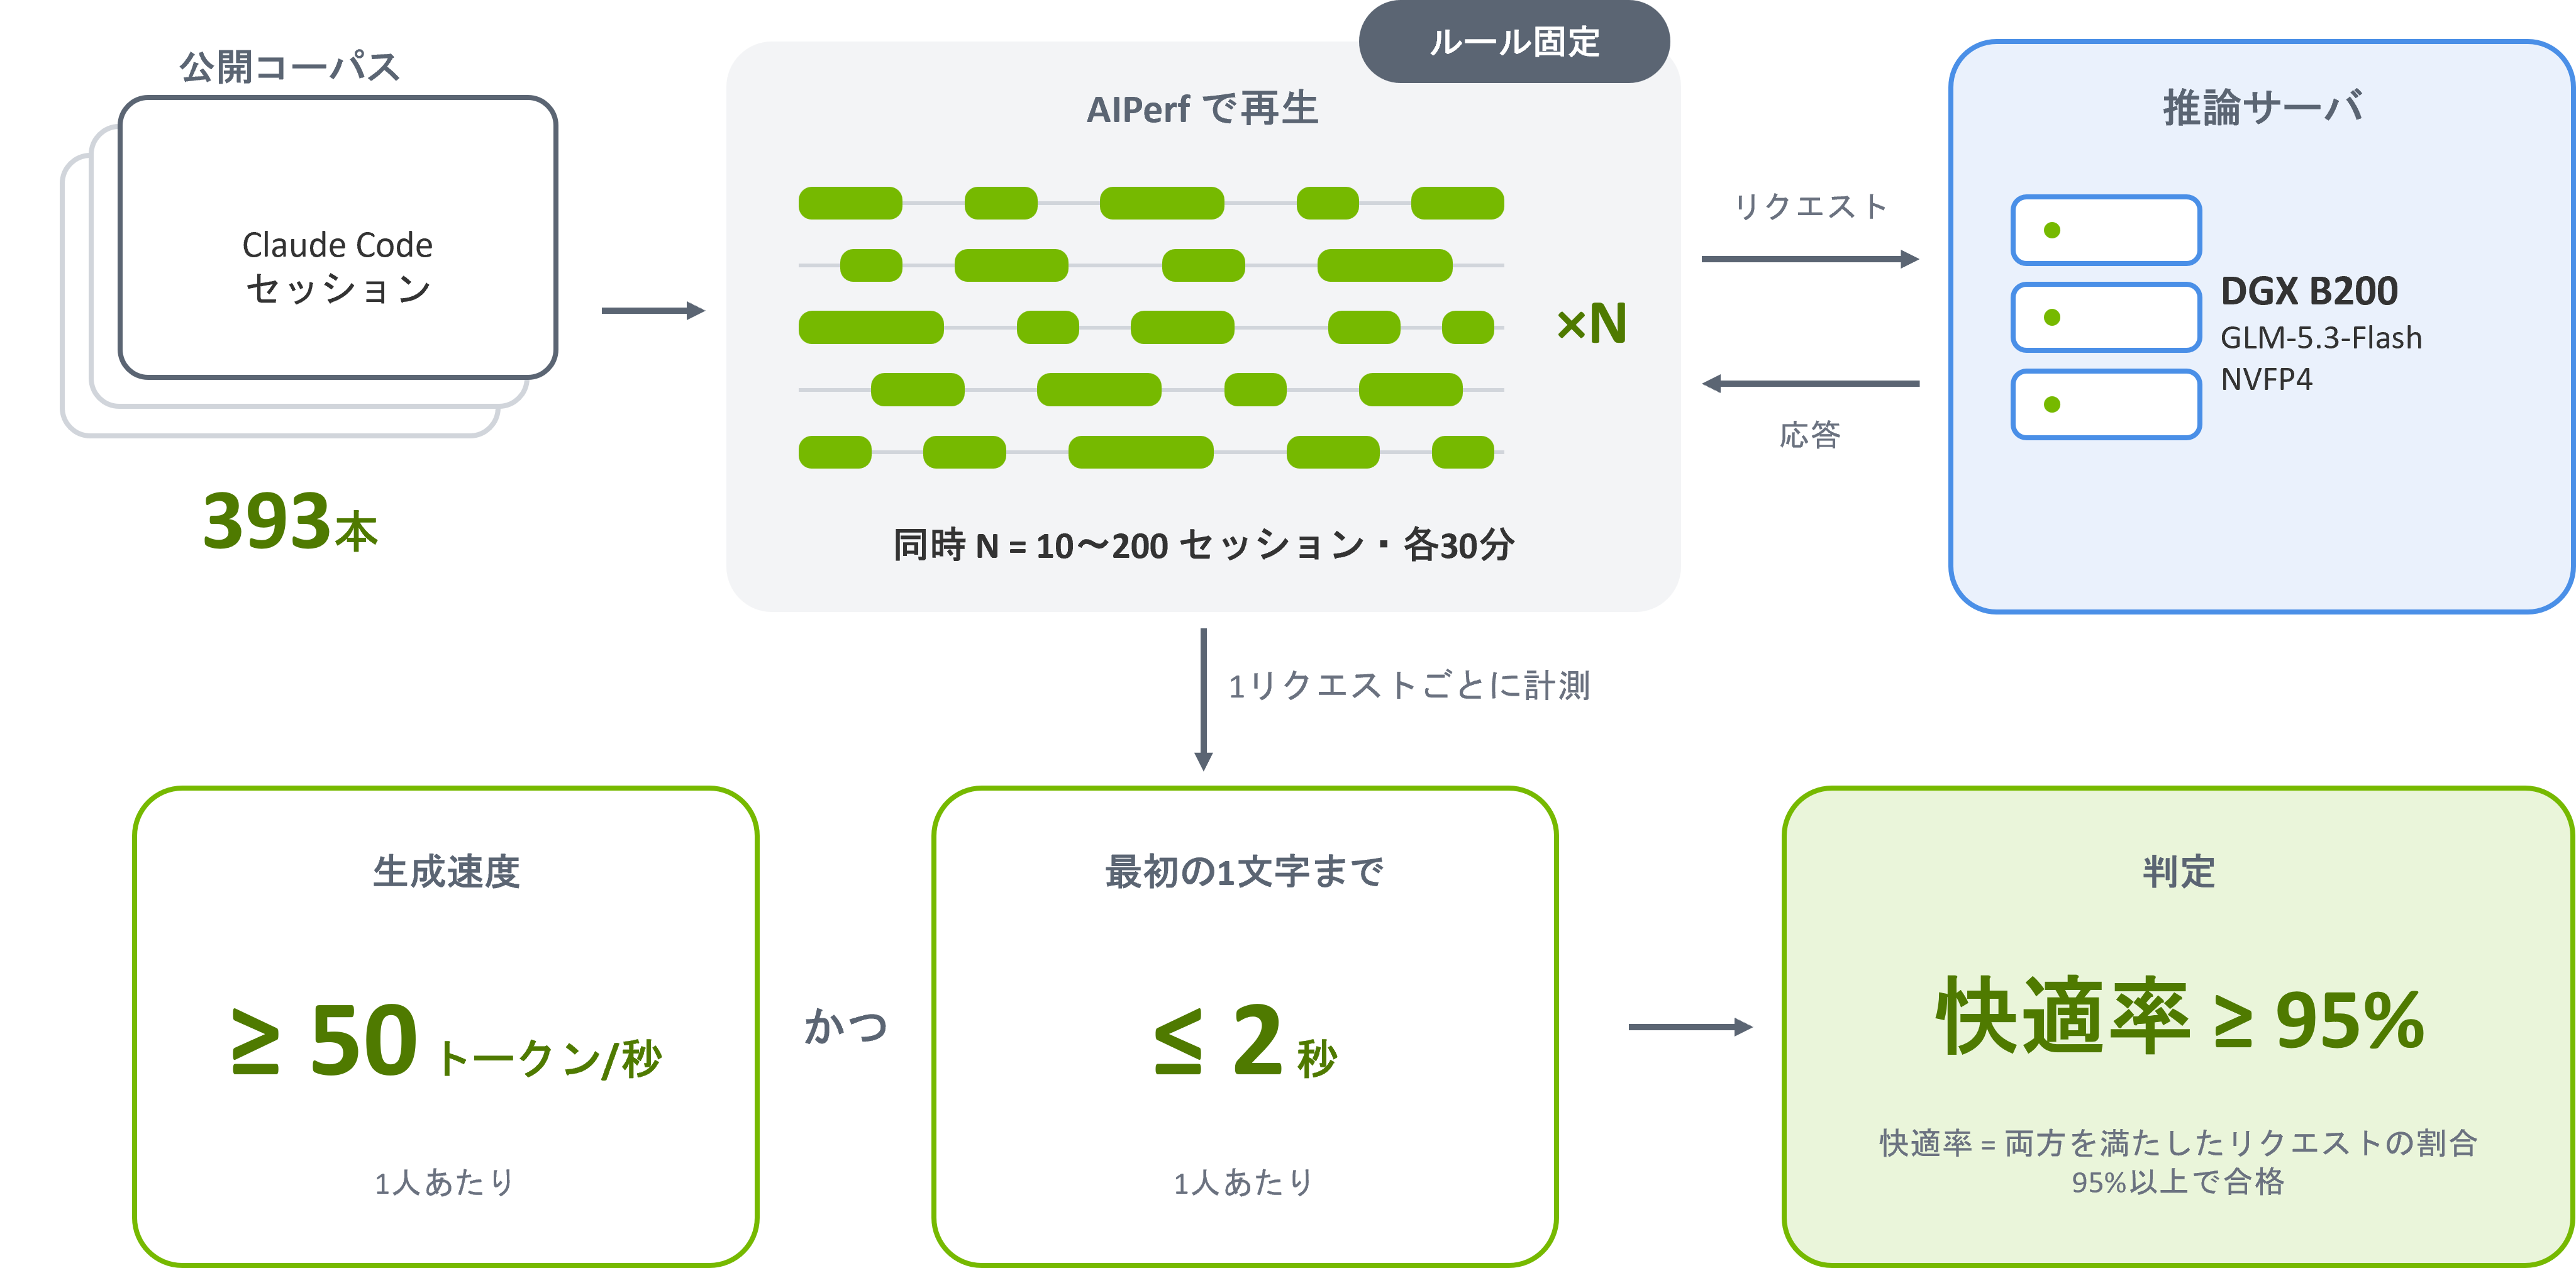
計測の全体像は上図のとおりです。実際のセッションを再生する会話を同時にN本実行し(同時セッション数N本)、会話が終わるたびに別のセッションを割り当てて、常にN本の会話が進行している状態を保ちます。たとえば同時セッション数50本は、50個のエージェントが常時並列で動作している負荷に相当します。
会話の合間にはツールの実行や、人の操作を模した間隔、SubAgentを模したリクエストの送信も入ります。そのため、推論サーバが実際に同時に処理しているリクエストの数(同時処理リクエスト数)は、同時セッション数に対して増減します。以降は、1本の会話を1人の利用者とみなし、同時セッション数N本を同時利用者数N人として扱います。会話が終わるとすぐに次の会話が始まり、常にN人が作業している状態が続くため、実際の利用よりも重い負荷です。
評価の基準(SLO)は、計測の前に次のように定めました。AgentX MVPが固定するのは実行条件(セッションの再生順序・間隔など)だけで、「何を快適とみなすか」は計測する側が定めるものです。
🔷快適 = 「1人あたり50トークン/秒以上かつ最初の1文字まで2秒以内」を満たしたリクエストが全体の95%以上
50トークン/秒は、第1話で紹介したクラウドAPIの出力速度(Opus 4.8で約55トークン/秒)を目安に定めました。クラウドで使っていたときと同程度の速度を保てれば、オンプレミスに切り替えても使い勝手は落ちない、という考え方です。2秒の基準はユースケースによって変わりますが、今回は、単純な1問1答ではなくツールを呼び出しながら複数ターン動くエージェントの利用を想定して定めました。これらの指標は、実際のユースケースにあわせて適宜変更してください。計測は、同時セッション数を10・30・50・100・150・200本の6段階に変えて行いました。
計測条件:ハードウェアと実行環境
今回の計測は、次の条件で行いました [3][4]。
項目条件
|
項目条件 |
項目条件 |
|
ハードウェア |
NVIDIA DGX™ B200 1台(NVIDIA Run:ai上で稼働) |
|
モデル |
nvidia/GLM-5.3-Flash-NVFP4 |
|
推論エンジン |
vLLM(プレフィックスキャッシュ有効、KVキャッシュはFP8) |
|
TP |
8 |
|
ベンチマーク |
AgentX MVP(AIPerf 0.13.0 の inferencex-agentx-mvpシナリオ) |
|
コーパス |
semianalysis_cc_traces_weka_062126(Claude Codeのセッション393本) |
|
同時セッション数 |
10 / 30 / 50 / 100 / 150 / 200本の6段階 |
|
計測時間 |
各30分(1,800秒) |
|
乱数シード |
42 |
|
計測日 |
2026年9月17日 |
計測結果:同時50人まで基準を達成
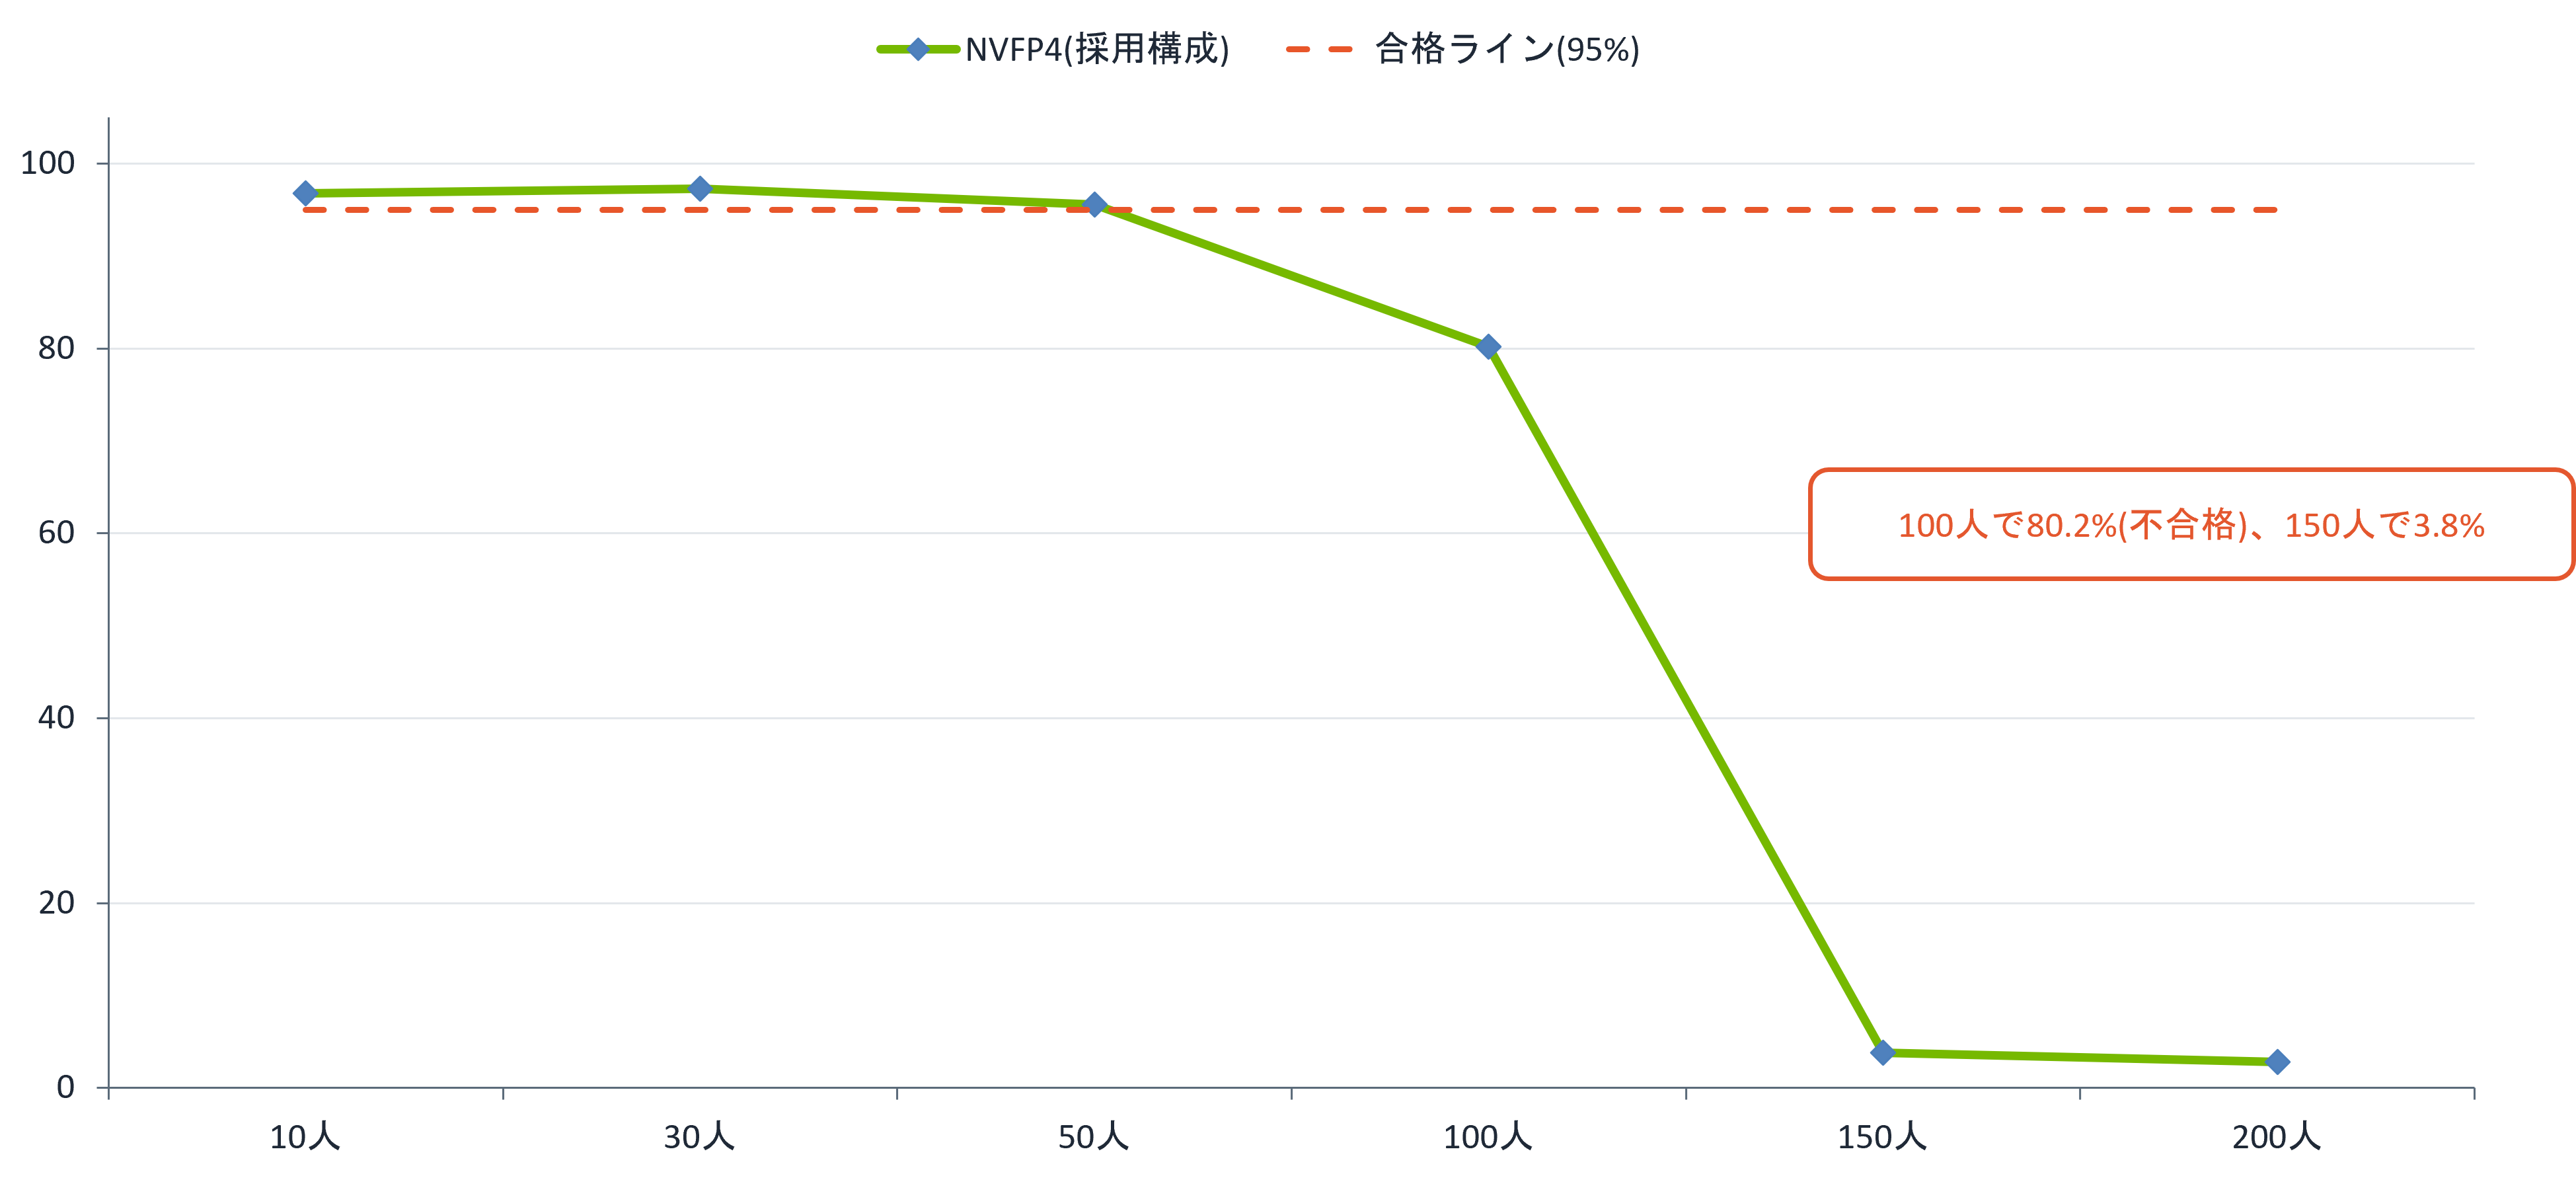
同時利用者数ごとの快適率は上図のとおりです。同時10〜50人では快適率95%以上を保ち、基準を満たしました。同時100人では80.2%に下がって基準を下回り、同時150人では3.8%まで落ちます。以降は、基準を満たした最大の人数である同時50人の結果を詳しく見ます。
|
指標 |
平均 |
|
1人あたりの生成速度 |
約100トークン/秒約0.59秒 |
|
最初の1文字までの待ち時間 |
約0.59秒 |
快適率は95.6%で、基準を満たしました。生成速度と待ち時間は、リクエスト単位の分布です。生成速度は平均で約100トークン/秒と、基準(50トークン/秒)の2倍以上を保っています。待ち時間も平均で約0.59秒と、基準の2秒を大きく下回っています。快適率は、生成速度と待ち時間の両方の条件を満たしたリクエストの割合を表します。
同時50人の計測では、30分間に1,840件のリクエストを処理しました。1リクエストあたりの入力は平均約10.8万トークン(中央値約8.3万トークン)、出力は平均約910トークン(中央値347トークン)で、長い入力に短い出力を返す、エージェント利用に特有の負荷です。会話の合間の間隔があるため、同時処理リクエスト数は平均10件前後でした。利用者30名が日常的に使う環境として、十分な速度が出ていることを実測で確認できました。
また、推論サーバ側で計測したプレフィックスキャッシュのヒット率は、同時50人で94.3%でした。同時10〜100人でも93〜96%と高く、エージェントの利用では同じプロンプトの先頭部分が繰り返し使われることが分かります。この値は、後のコスト試算の前提になります。
ここで示した数字は、最適化を行った結果ではなく、一般的な構成(vLLM+量子化モデル)で得られたものです。新しいモデルのリリースも速く、実際のSLA、利用する人数、ユースケースによっても条件は異なるため、導入を検討される際は、自社の環境でベンチマークを測定することを推奨します。具体的な構成と測定方法は、第3話で解説します。
同時利用者数から利用者数への換算
同時利用者数と利用者数は異なります。利用者が30名いても、全員が同時にエージェントに作業を依頼している時間は多くありません。
そこで、利用者のうちピーク時に同時に利用している人の割合(ピーク同時利用率 = ピーク時の同時利用者数 ÷ 利用者数)を使って換算します。ピーク同時利用率を高めに見積もって50%とすると、同時50人で合格という結果は利用者100名規模に相当します。30%とすれば約170名です。ただし、同時100人では基準を下回る点には注意が必要です。
現在の利用者30名は、同時利用者数に直すと10〜15人程度と想定されるため、処理能力には大きな余裕があります。この「同時利用者数」と「利用者数」の区別は、コスト試算にも関わってきます。
コスト試算: 何名の利用で元を取れるのか?
ここからは、もう1つの疑問、コストの試算に進みます。初期投資1億円の環境は、同じ利用量を外部APIで使った場合の年間費用と比べて、何名の利用で元を取れるのかというのが気になるところです。
試算は、次の順番で整理します。
1. 試算の前提: 実運用のデータと、オンプレミス側の年間コスト
2. 試算: 同じ量を外部APIで処理した場合の年間費用(プロンプトキャッシュの有無別)
3. 試算結果: 利用者数ごとに、外部APIとオンプレミスの年間コストを比較
4. 参考: エージェントの利用がさらに広がった場合の年間費用
5. 数値に表れない価値と注意点
チームの運用はオンプレミスで完結しているため、試算もオンプレミスのみで運用する前提で行います。
試算は、2026年9月15日に確認したAPI単価と、2026年9月時点の為替レートに基づきます。為替と単価は変動するため、金額そのものよりも前提と計算式を確認し、自社の数字に置き換えて使ってください。計算の過程は第3話で紹介します。
|
前提 |
値 |
|
為替 |
1USD=160円 |
|
年間の営業日 |
240日 |
|
キャッシュヒット率 |
90%(基準)と95%の2通り |
|
初期投資(GPUサーバなどの設備) |
1億円を5年で定額償却 [5] |
|
ランニングコスト(電気代など) |
1,800万円/年(弊社の概算) |
試算の前提: 実運用データ
|
項目 |
実績 |
|
利用者数 |
約30名 |
|
リクエスト数 |
約4,300件/日(年間約102.7万件) |
|
トークン量 |
年間 Input 約1,317億 / Output 約5.4億(NVIDIA NeMo™ Switchyardのメトリクスから集計) |
|
比較単価 |
Claude Opus 4.8 API標準料金(Input $5 / Output $25 per MTok)[6] |
|
キャッシュ時の単価 |
読み込み(ヒット) $0.50 / 書き込み(5分キャッシュ) $6.25 per MTok [6] |
比較単価にOpus 4.8を使うのは、第1話で紹介したとおり、GLM-5.3-Flashが第三者機関の総合スコアでOpus 4.8と同点だったためです。
オンプレミス側の年間コストは次のとおりです。
・ 初期投資1億円: 5年定額償却で2,000万円/年 [5]
・ ランニングコスト(弊社の概算): 1,800万円/年
・ 合計: 約3,800万円/年
試算: 外部APIで同じ量を使った場合
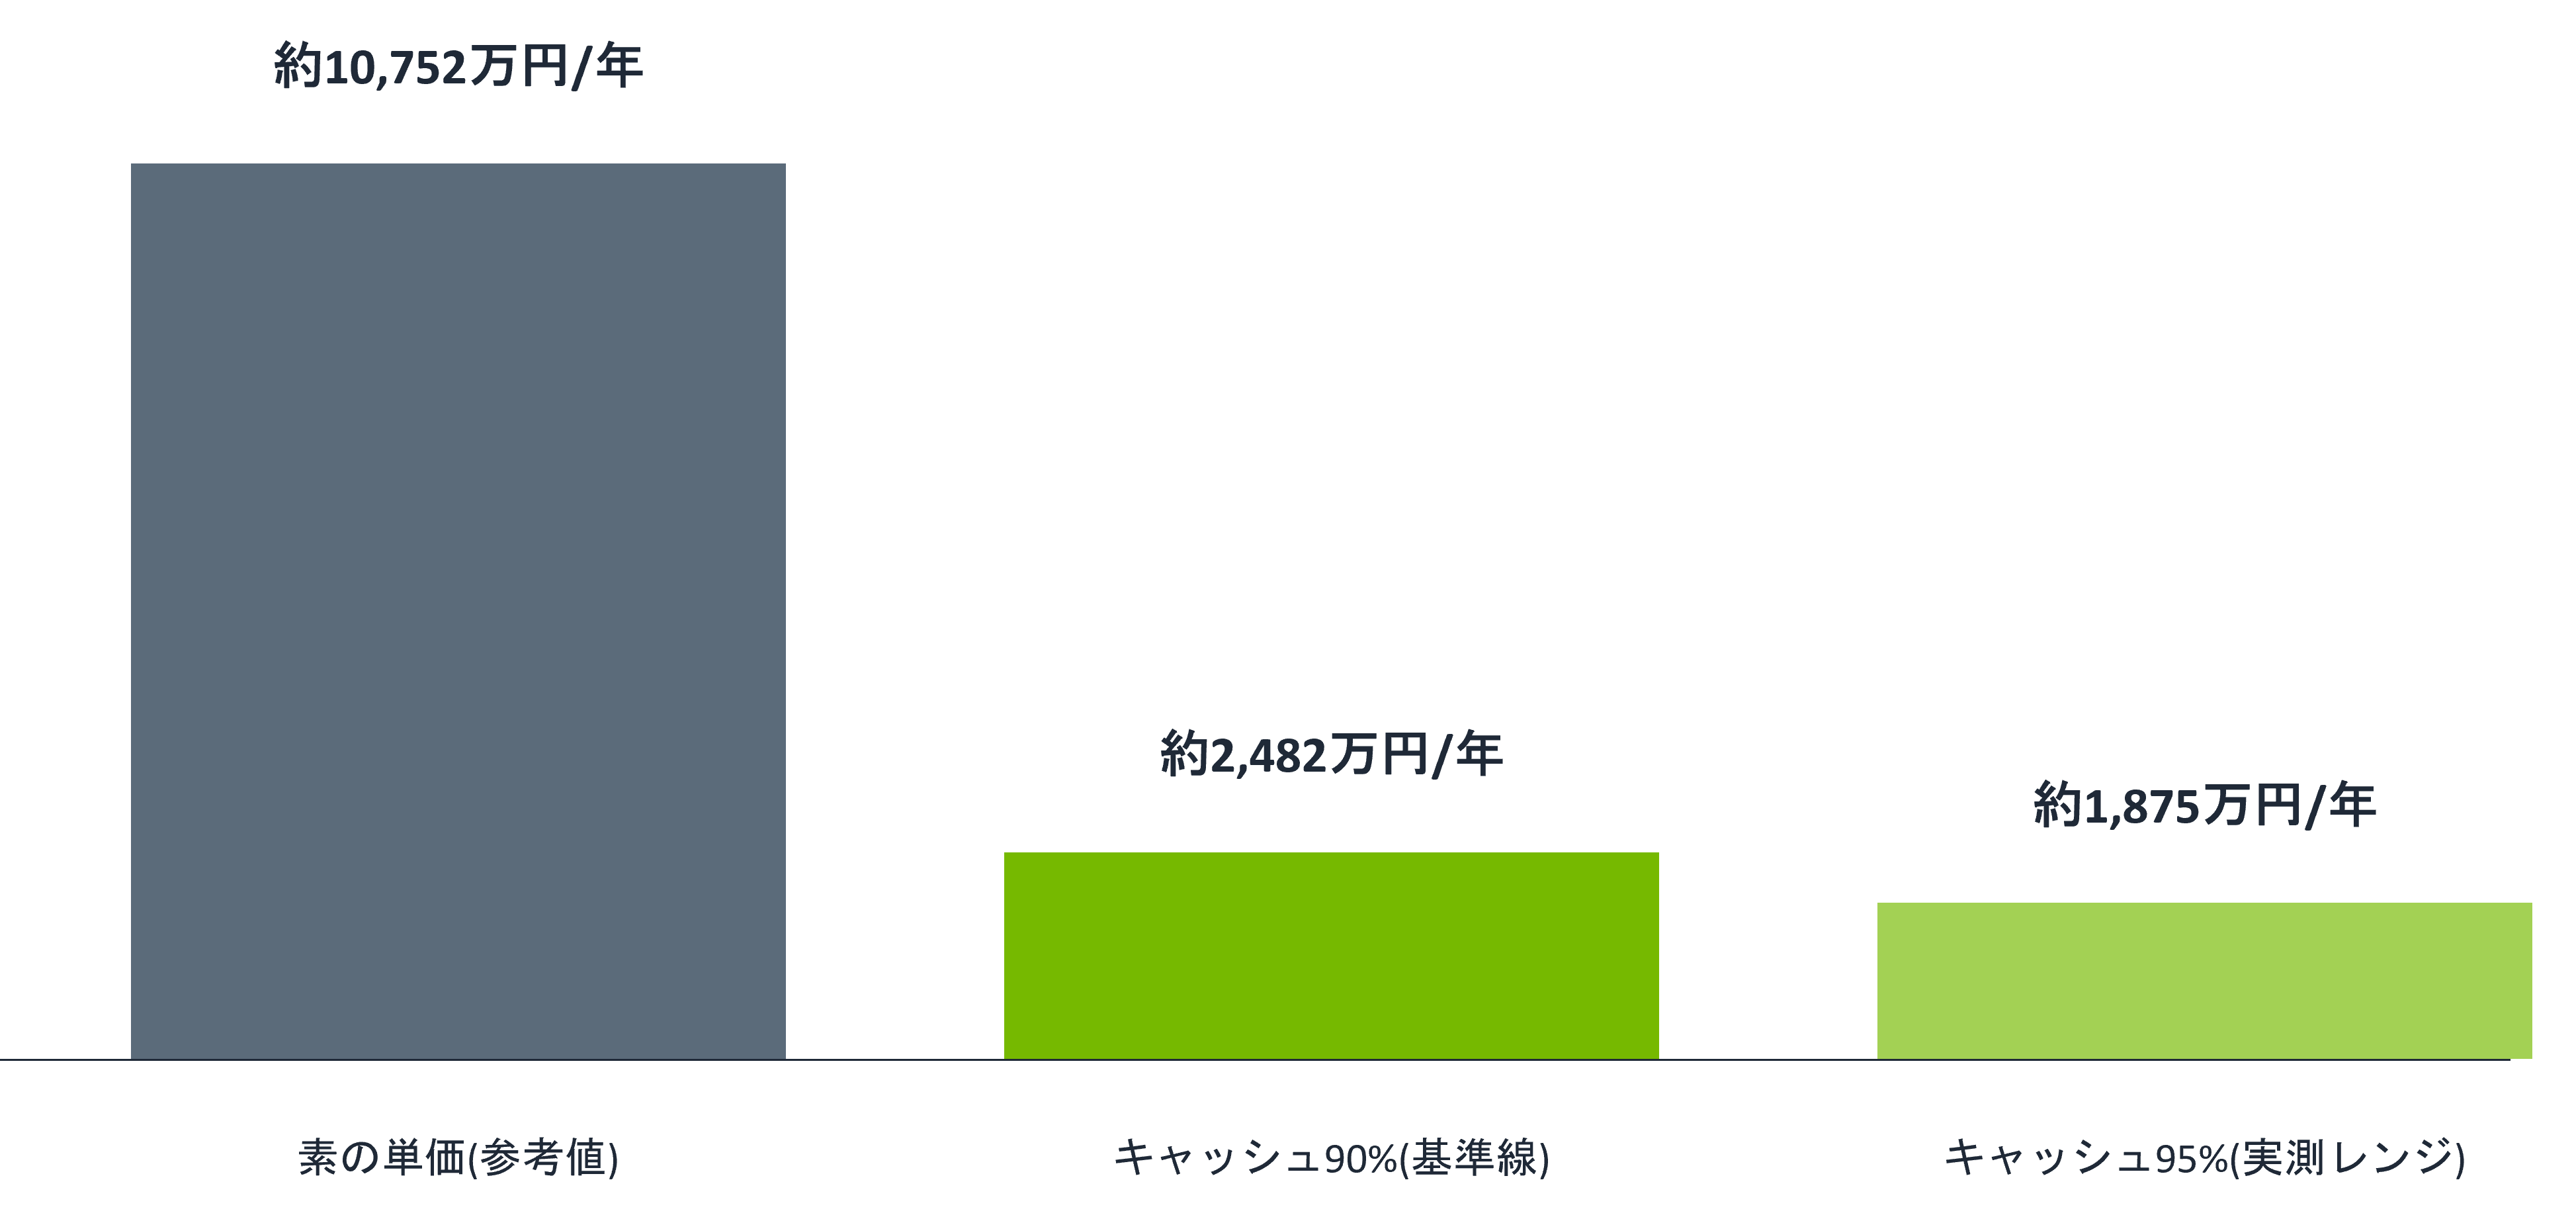
前節の前提(利用者約30名の実績利用量を、Opus 4.8の単価で評価する)にしたがって、年間費用を試算します。プロンプトキャッシュを一切使わずにすべての入力を標準単価($5)で払うと、年間約1億750万円になります。ただし、エージェントのクライアントは自動でプロンプトキャッシュを使うため、実際の請求額はこれより小さくなります。キャッシュを考慮した金額は、キャッシュにヒットした入力を読み込み単価($0.50)、ヒットしなかった入力を書き込み単価($6.25)で計算しました。
|
キャッシュヒット率 |
年間API相当額 |
キャッシュなしとの比較 |
|
なし(参考) |
約1億750万円/年 |
− |
|
90%(基準) |
約2,480万円/年 |
▲77% |
|
95%(性能測定の実測に近い値) |
約1,880万円/年 |
▲82% |
性能測定では、推論サーバ側のキャッシュヒット率は93〜96%でした。エージェントの利用では、同じプロンプトの先頭部分が繰り返し使われるためです。キャッシュを考慮しても、外部APIで同じ量を処理すれば、年間2,000万円前後の費用がかかります。
試算結果: 約45〜60名
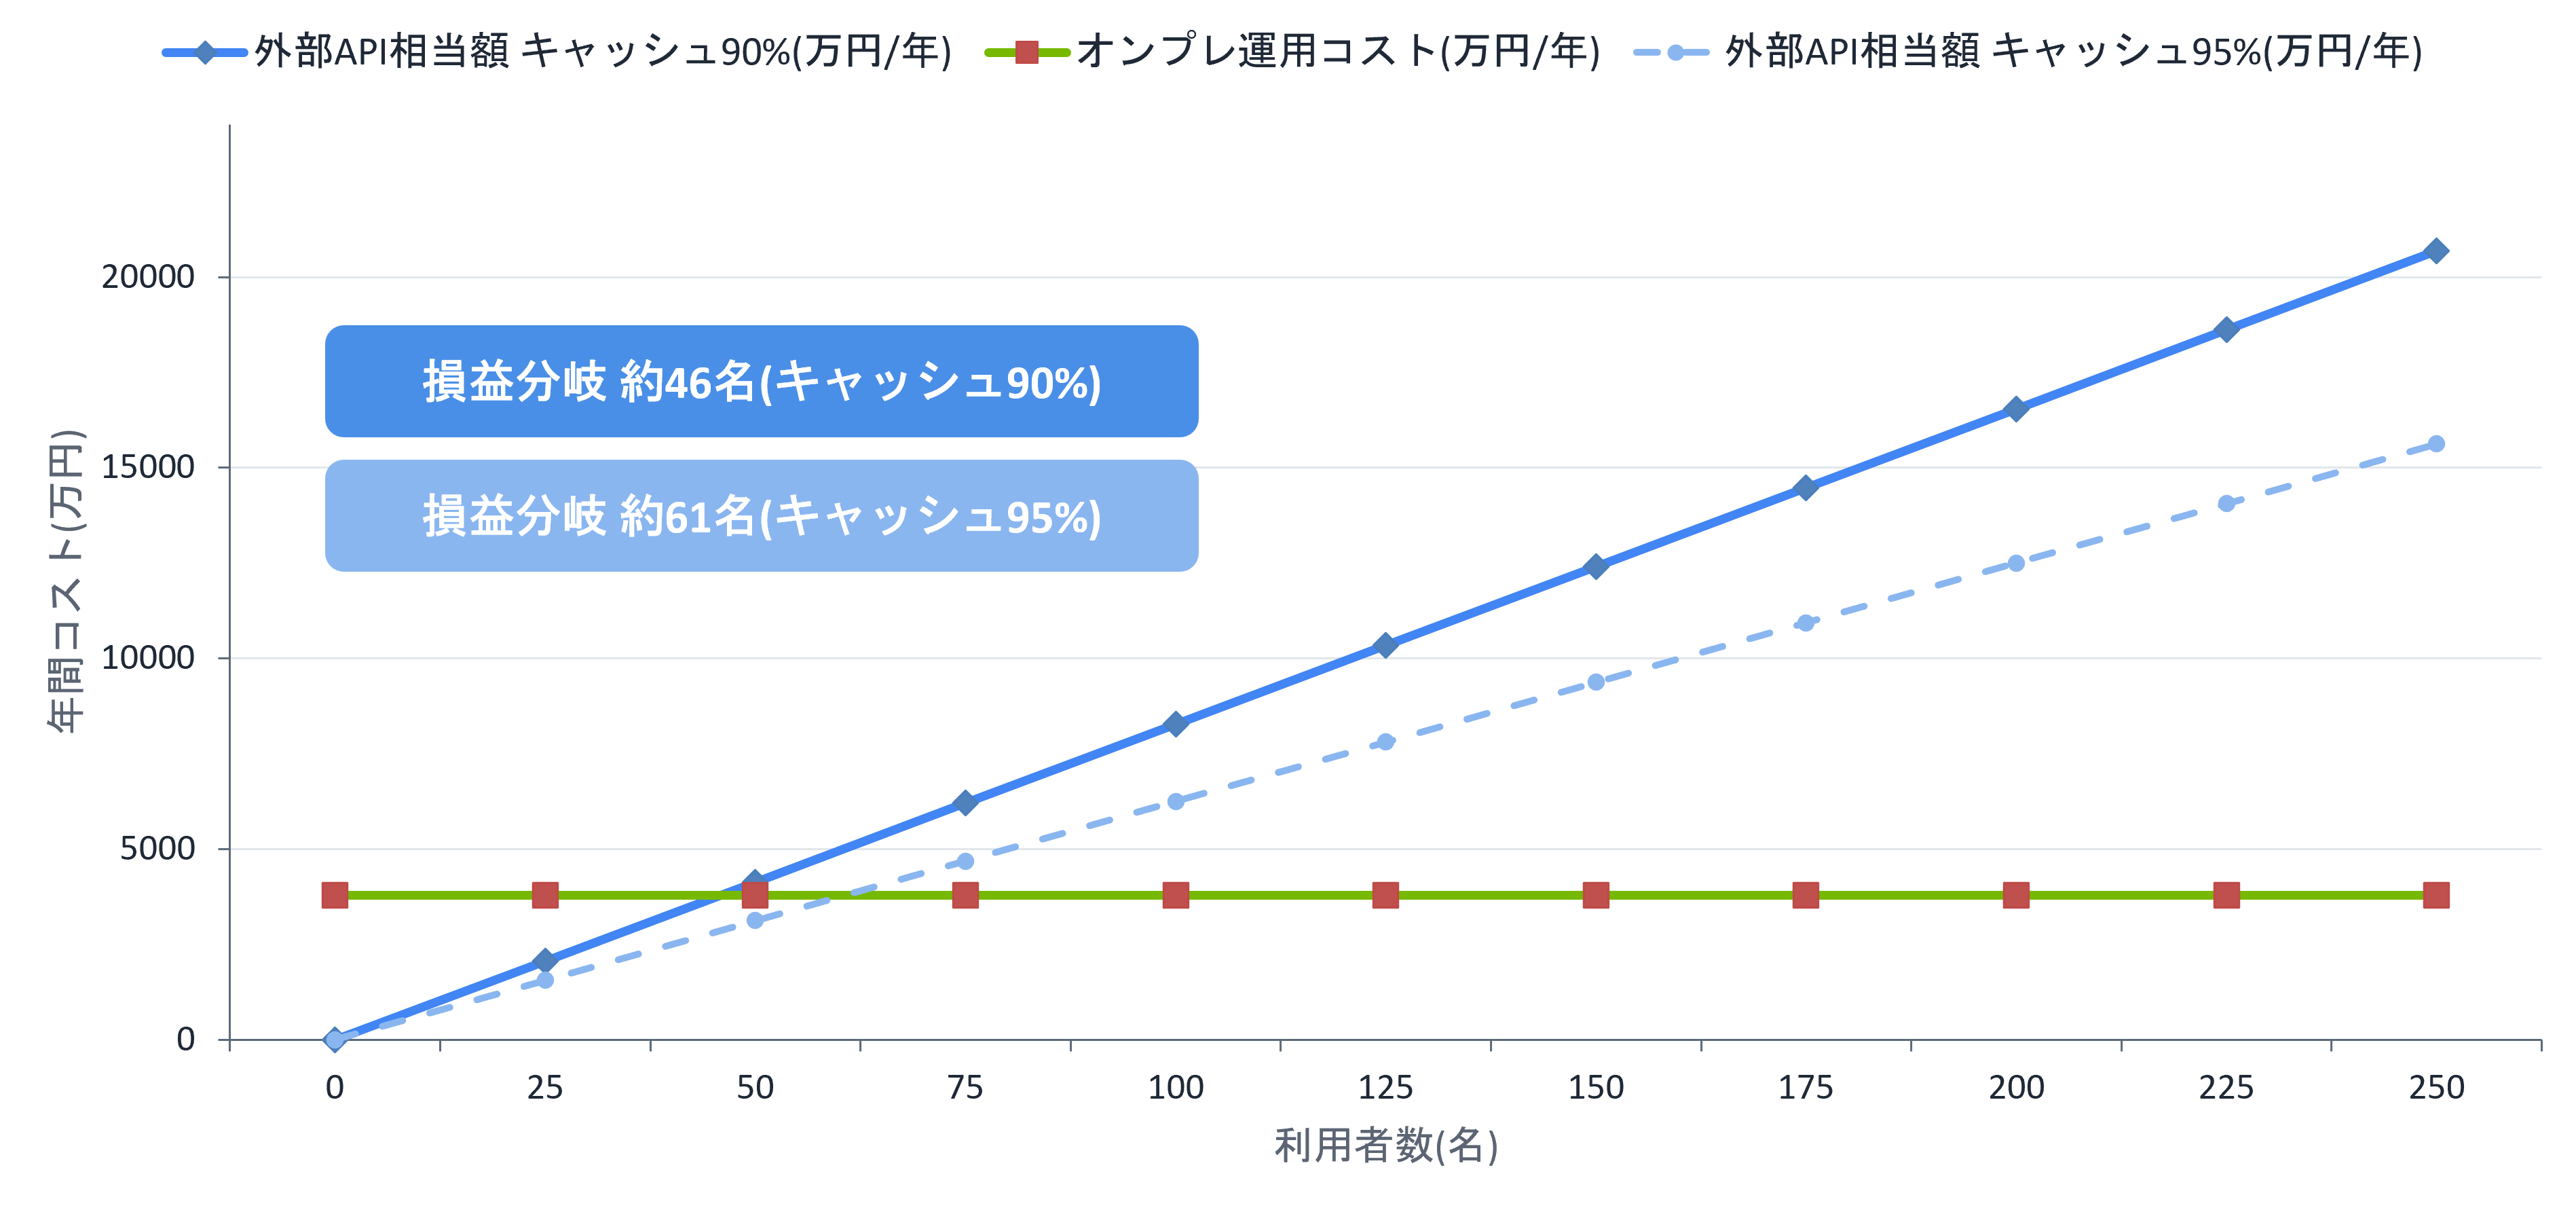
オンプレミス側の年間コスト(約3,800万円)を、利用者数ごとの外部API相当額(利用者30名の実績を利用者数で比例配分)と比べます。キャッシュヒット率は、90%と95%の2通りで計算しました。
キャッシュヒット率90%(基準)の場合
|
利用者数 |
同時利用者数 (ピーク同時利用率30〜50%想定) |
API相当額/年 |
オンプレミス TCO/年(償却込み) |
年間差額 |
初期1億円の回収期間※ |
|
30名(現在) |
10〜15人 |
約2,480万円 |
約3,800万円 |
▲1,320万円 |
約15年(耐用5年内に回収不能) |
|
50名 |
15〜25人 |
約4,140万円 |
約3,800万円 |
+340万円 |
約4年3ヶ月 |
|
60名 |
18〜30人 |
約4,960万円 |
約3,800万円 |
+1,160万円 |
約3年2ヶ月 |
|
100名 |
30〜50人 |
約8,270万円 |
約3,800万円 |
+4,470万円 |
約1年6ヶ月 |
|
150名 |
45〜75人 |
約1億2,410万円 |
約3,800万円 |
+8,610万円 |
約11ヶ月 |
キャッシュヒット率95%の場合
|
利用者数 |
同時利用者数 (ピーク同時利用率30〜50%想定) |
API相当額/年 |
オンプレミス TCO/年(償却込み) |
年間差額 |
初期1億円の回収期間※ |
|
30名(現在) |
10〜15人 |
約1,880万円 |
約3,800万円 |
▲1,920万円 |
回収不能 |
|
50名 |
15〜25人 |
約3,130万円 |
約3,800万円 |
▲670万円 |
約7年7ヶ月(耐用5年内に回収不能) |
|
60名 |
18〜30人 |
約3,750万円 |
約3,800万円 |
▲50万円 |
約5年2ヶ月(耐用5年内に回収不能) |
|
100名 |
30〜50人 |
約6,250万円 |
約3,800万円 |
+2,450万円 |
約2年3ヶ月 |
|
150名 |
45〜75人 |
約9,380万円 |
約3,800万円 |
+5,580万円 |
約1年4ヶ月 |
※表中の「初期1億円の回収期間」と「年間差額」は、計算方法が異なります。なお、金額は10万円単位で丸めています。
・初期1億円の回収期間:
初期投資1億円を、「API相当額 − ランニングコスト1,800万円」で求めた年間の節約額で割った年数です。償却費を差し引かないのは、償却費が初期投資1億円そのものを年割りした額であり、ここで差し引くと同じ1億円を二重に数えることになるためです。
・年間差額
償却費を含む年間コストで比較した差額です。プラスであれば、耐用年数5年の間の総額でオンプレミスが有利であることを意味します。
償却込みの年間コストが釣り合う損益分岐は、キャッシュヒット率90%で約45名、95%で約60名です。初期投資を3年で回収するには、90%で約60名、95%で約80名が必要です。一方で、この表のシナリオは、性能測定で確認した範囲におさまります。現在の利用者30名は、同時利用者数に直すと10〜15人程度と想定され、性能には十分な余裕があります。同時50人で基準を達成した結果は、利用者100名規模(ピーク同時利用率50%)から170名規模(同30%)に相当するため、50〜100名のシナリオは十分に収容できます。150名のシナリオも、ピーク同時利用率が30%なら同時45人で、基準を満たす範囲におさまります。
参考:ベンチマークと同じ負荷で使い続けた場合
エージェントの利用がさらに広がった場合の目安として、性能測定のベンチマークと同じ負荷を、長い時間使い続けた場合を試算します。条件は次のとおりです。
|
項目 |
条件 |
|
負荷 |
AgentX MVP 同時50人(基準を達成した条件)の1人あたりの利用ペース |
|
稼働時間 |
1日8時間×年間240日(参考として24時間×365日も試算) |
|
単価とキャッシュ |
Claude Opus 4.8 API、キャッシュヒット率90% |
試算の結果は次のとおりです。
・1人あたりの年間API相当額は約315万円(キャッシュ90%)
・利用者50名では年間約1億5,800万円。オンプレミス運用のコスト(年約3,800万円)との差は年間約1億2,000万円で、初期投資1億円は1年弱で回収できる規模
さらに、夜間や休日もエージェントが作業を続け、1日24時間・年間365日動かした場合(上記の4.56倍)は、1人あたり年間約1,440万円(キャッシュ90%)、利用者50名で年間約7.2億円になります。このペースは、現在の実際の使い方の約3.5倍の負荷です(1人あたりの年間入力トークンで比較)。
ただし、エージェントが常時働き続ける使い方は、すでに現実のものになりつつあります。NVIDIAは2026年5月、工場の状況を常に監視しながら多数の専門エージェントを統括する「工場管理エージェント」を構築するためのリファレンス設計として、NVIDIA Factory Operations Blueprint(FOX)を発表しました [7]。エージェントが人に代わって働き続けるようになると、外部APIの費用は年間数億円規模になり、初期投資が固定のオンプレミスとの差は利用量に比例して広がります。
数値に表れない価値と注意点
回収の計算には表れない価値もあります。1つは、利用量を気にせずに使えることです。本連載の出発点だった「上限のために実行できなかった作業」を実行できるようになります。もう1つは、機密データを外部に送らずに済むことです。外部への送信が許されない業務では、コストを比べる以前に、オンプレミスが唯一の選択肢になります。
さらに、クラウドAPIへの依存に伴うリスクも、ここで解消されます。提供元の仕様変更やサービス停止があっても、オンプレミスの環境は自社でコントロールできるため、最低限のサービスを継続できます。外部APIの障害や値上げの影響を受けにくいことも、同じ観点の価値です。
注意点もあります。保守の人件費や運用の工数は、試算に含めていません。また、回収の計算はキャッシュヒット率に大きく左右されます。ヒット率が下がれば黒字化は早まり、上がれば遅れます。オンプレミスのモデルだけでは対応できない難しいタスクがある点にも注意が必要です。GPUの空き時間を夜間のバッチ処理などに活用できれば、回収を早められます。
まとめ
本記事では、性能とコストの2つの面から、オンプレミス環境の実力を確かめました。
性能面では、公開ベンチマークのAgentX MVPを使い、同時50人で快適率95.6%となり、基準を満たしました。1人あたりの生成速度は平均で約100トークン/秒、最初の1文字までの待ち時間は平均で約0.59秒でした。ピーク同時利用率(30〜50%)で換算すると、利用者100〜170名規模まで対応できる計算になります。
コスト面では、30名での実運用データをもとに、オンプレミス運用と外部APIのコストを比較しました。損益分岐点は、キャッシュヒット率90%の場合で約45名、95%の場合で約60名となり、100名を超えるとオンプレミスのコストメリットが明確になります。
また、損益分岐点から170名規模までは性能測定で確認した範囲に収まっており、今後の課題は技術面よりも、いかに社内展開を進めていくかにあります。小規模から試し、技術的な有効性を検証することは重要ですが、投資判断にあたっては、その先にどれだけ全社展開を見込めるかという視点も欠かせません。
また、エージェントが夜間や休日も働き続けるようになれば、外部APIの費用は年間数億円規模に達し、オンプレミスの優位はさらに広がります。
一方で、難しいタスクや判断のリスクが高いタスクは、クローズドのフロンティアモデルに任せることが適しています。こうしたタスクは頻度が低いため、APIの料金もわずかで済みます。日常の業務はオンプレミスで処理し、難易度が高いタスクだけをフロンティアモデルに任せる分担が、コストと品質の両面で有効だと考えています。
こうした分担を支えるのが、本連載のテーマであるハイブリッド推論基盤です。ぜひ貴社でも構築して、生成AIの全社活用を推進してみてはいかがでしょうか。
投資判断の前に、まず本連載で紹介したような環境を実際に触って確認したい方には、マクニカのAITRY NOW PROGRAMが便利です。 AIエージェント基盤をはじめとする最新のAIソフトウェアを導入前に検証できるプログラムで、本連載にあたる検証もAI TRY NOW PROGRAMの環境で実施しました(第1話参照)。
本番導入の段階では、マクニカには国内主要HPC・エンタープライズでのGPUクラスタ導入実績が多数あり、本連載で紹介したような自社運用のノウハウをもとに、環境構築から運用までを支援します。構築の段階では、物理・論理設計やポートマッピング、SoW策定といった導入前の設計から、ラッキング・配線やハードウェア検証、FW更新・OS導入、ジョブスケジューラやNCCLなどのクラスタ構成、そしてSystemレビューやトレーニング、引継ぎ資料の作成までを一貫して行います。運用の段階では、Run:aiの運用やLLMのデプロイ、性能測定に加え、本連載のテーマであるハイブリッド推論環境の構築支援、NVIDIA NemoClawなどのエージェント活用支援もご相談いただけます。
検証の段階から本番導入まで、お気軽にご相談ください。
第3話では、今回構築した環境の中身(ルーティング・ベンチマーク)を、エンジニア向けに解説します。
引用文献
- [1] SemiAnalysis, “InferenceX by SemiAnalysis — Open-Source Agentic Inference Benchmark”
- [2] SemiAnalysis, “cc-traces-weka-062126”(Hugging Face データセット、Claude Codeのセッション 393本)
- [3] NVIDIA, “InferenceX AgentX MVP Benchmark — NVIDIA AIPerf Documentation”
- [4] ai-dynamo, “AIPerf” (GitHub)
- [5] 国税庁, “主な減価償却資産の耐用年数表”
- [6] Anthropic, “Pricing — Claude Platform Docs”
- [7] NVIDIA Blog, “NVIDIA Factory Operations Blueprint Gives Factories a New AI Brain”
お問い合わせ