- 半導体事業HOME
- マクニカの製品・サービス
-
技術情報

-
イベント・セミナー
- 取扱メーカー
- サポート
- お問い合わせ
- 製品購入はこちら
- 半導体事業のメルマガ登録


 条件を指定して絞り込む
現在2259件がヒットしています。check
はじめに
AIエージェントを業務で使っていて、作業の途中で利用上限に達し、手が止まってしまった経験はないでしょうか。クラウドのサービスは便利ですが、契約プランごとに使用量の上限があり、使いたいときに十分に使えないことがあります。またもう1つの壁がセキュリティです。顧客データやソースコード、未公開の成果物など、外部に送れない機密情報を扱う業務では、クラウドのサービスにプロンプトを送ること自体が制限の対象になります。便利なツールほど最初に打ち込む情報量は多いため、「この情報を出してよいか」という判断が利用のたびに発生し、結果として活用が進まない一因になります。そのほかにも、APIではセーフガードが働くため、実施できないセキュリティ関係のタスクなども存在します。
一方で、オープンウェイトのLLMは公開ベンチマークでフロンティアモデルに迫る性能を示すようになりました。自社の環境でエージェントを動かせないか、と考えている方も多いのではないでしょうか。ただ、いざ導入を検討しようとすると、判断材料はあまり見つかりません。
・ 業務で本当に使えるのか
・ 何人の同時利用に耐えられるのか
・ 投資を回収できるのか
こうした疑問に答える実測データは、まだほとんど公開されていません。
本連載では、私たちのチームが社内30名のAIエージェント利用をクラウドからオンプレミスへ移行した事例を、実測データとともに紹介します。
連載は3話構成で、各話で次の内容を扱います。
◆第1話:移行の経緯と構成
— 日常業務をオープンウェイトのLLMでどこまで賄えるのか。ハイブリッド推論環境の構成と、私の実業務での検証結果(411リクエストのうち402件がオンプレミスで完結)を紹介します。
◆第2話:性能とコストの検証
— GPUサーバー1台で何人分のエージェントを支えられるのかを、公開ベンチマークで定量的に測定します。あわせて、初期投資1億円の環境が何名の利用で元を取れるのかを、実運用データから試算します。
◆第3話:技術的な詳細
— ルーティングの仕組みと設定ファイル、ベンチマークの実行方法、コスト試算の計算過程など、同じ環境を自分で構築するための中身を解説します。
記事中の数値は2026年9月時点の実測値・実運用データです。為替、API単価、ベンチマーク結果は変動するため、導入を検討する際は最新の情報を確認してください。
背景:クラウドサービスの利用上限
移行前、社内のエージェント利用はClaude(Team plan)、Microsoft 365、Github Copilotを中心としたクラウドサービスで行っていました。これらは契約プランごとにシート数と使用量の上限が決まっており、上限に達すると作業を継続できません。また、社員全員へは展開されていないサービスもあり、生成AIの活用が進んでいない一因となっていました。エージェントの利点は、タスクを任せている間に別の作業を並行して進められることにあります。利用量を気にしながら使う状況では、この利点を十分に活かせません。加えて、従量課金に切り替えた場合のコスト増や、機密情報を外部に送信することへの懸念もありました。
このほかにも、クラウドAPIへの依存には、上記とは性質の異なる2つの懸念がありました。1つは、提供元の仕様変更やサービス停止によって、業務の継続が困難になるリスクです。このリスクは、契約や運用の工夫だけでは解消が難しいという点で厄介です。もう1つは、プロバイダー側のセーフガードなどが働くことで、すべてのタスクを解決できるわけではない点です。対応できないタスクが残ることは、活用できる範囲の上限にもなります。そこで、日常業務を担うモデルをオンプレミスに置くことを検討しました。
検討のきっかけ:オープンウェイトLLMの性能向上
数年前のローカルLLMは、応答速度・性能の両面で業務に使える水準ではありませんでした。しかし、オープンウェイト(重みが公開され、誰でもダウンロードできる)モデルの性能は急速に向上しています。今回採用したのは、Z.aiのzai-org/GLM-5.3-Flashです。前の世代のフロンティアモデルであるClaude Opus 4.8と同等の水準に達しています。また、GLM-5シリーズで初めてネイティブにマルチモーダルに対応したモデルで、テキストだけでなく画像や動画も入力として扱えます [1]。
実際の運用では、NVIDIAがこのモデルを4ビット(NVFP4)に量子化したnvidia/GLM-5.3-Flash-NVFP4を使っています [2]。量子化後も、精度は元のモデルとほぼ同等に保たれています(GPQA Diamondで元のモデル0.9217に対し0.9211)。マルチモーダルの入力にもそのまま対応しています。
| モデル | Intelligence Index [3] | 区分 |
| Claude Opus 5.5 | 58 | 最新フロンティア(クローズド、今回のエスカレーション先) |
| GPT-6 Astra | 53 | 最新フロンティア(クローズド) |
| Claude Opus 4.8 | 42 | 前の世代のフロンティア(クローズド) |
| GLM-5.3-Flash | 42 | オープンウェイト(今回はNVFP4版を使用) |
※Artificial Analysis Intelligence Index v4.3.2。コーディングやエージェント系を含む10種類の評価を合成した総合スコアです。推論設定のあるモデルは最大設定(max)の値。(2026年9月25日時点)
第三者機関による総合スコアで、GLM-5.3-FlashはOpus 4.8と同点です。一方、最新のOpus 5.5やGPT-6とは依然として差があります。フロンティア級の性能を持つものの、最前線のモデルには及ばないという位置づけです。この差が、後述する「難しいタスクはフロンティアモデルに任せる」という方針の根拠になります。応答速度についても、クラウドAPIと同等以上の結果が得られています。Artificial Analysisの計測では、Opus 4.8をAnthropic APIで利用した場合の出力速度は約55トークン/秒です(2026年9月15日確認)[4]。これに対し、今回のオンプレミス環境は50人が同時に利用している状態でも、1人あたり約100トークン/秒を維持しています(第2話)。モデルも計測方法も異なるため厳密な比較ではありませんが、実用上の速度は十分です。
こうした性能向上を受けて、社内に環境を構築して検証することにしました。
クラウドのみ・オンプレミスのみにしない理由
前節までの課題への対策としては、大きく分けて3つの方向が考えられます。クラウドAPI(マネージドサービス)のみで使い続けるか、オンプレミス+オープンモデルのみへ切り替えるか、あるいは両者を組み合わせるかです。それぞれの特長を、課題の観点ごとに整理したものが次の表です。
|
観点 |
クラウドAPIのみ |
オンプレミス+オープンモデルのみ |
ハイブリッド |
|
利用上限 |
× 上限到達で作業が止まる |
〇 上限なく使える |
〇 日常業務は上限なし |
|
コスト |
× 従量課金で利用量に比例して増大 |
△ 固定費中心だが初期投資が必要 |
〇 一定規模以上でAPIより有利(第2話で試算) |
|
機密情報 |
× 外部送信のリスクが残る |
〇 データは社外に出ない |
〇 機密情報はオンプレミスで処理 |
|
難タスクの品質 |
〇 最新フロンティアモデルが使える |
× 最新フロンティアには及ばない |
〇 難所だけクラウドへ |
|
サービス継続 |
× 急な停止のリスクがある |
〇 自社でコントロール |
〇 オンプレミスだけで最低限のサービスを継続 |
この表からも分かるとおり、クラウドのみでは前節までの課題が残り、オンプレミスのみでは最新フロンティアモデルに及ばない難しいタスクの品質が課題になります。そこで私たちは、日常業務はオンプレミスで処理し、難所だけをクラウドのフロンティアモデルへ振り分けるハイブリッド構成を採りました。
構成:オンプレミス環境とクラウドへのルーティング
用意したのは、GPUサーバ(NVIDIA DGX™ B200)1台とオープンウェイトのモデルです。GPUは部門間で共有できるようにしています。
この環境は、弊社のAI TRY NOW PROGRAMで検証しています [5]。
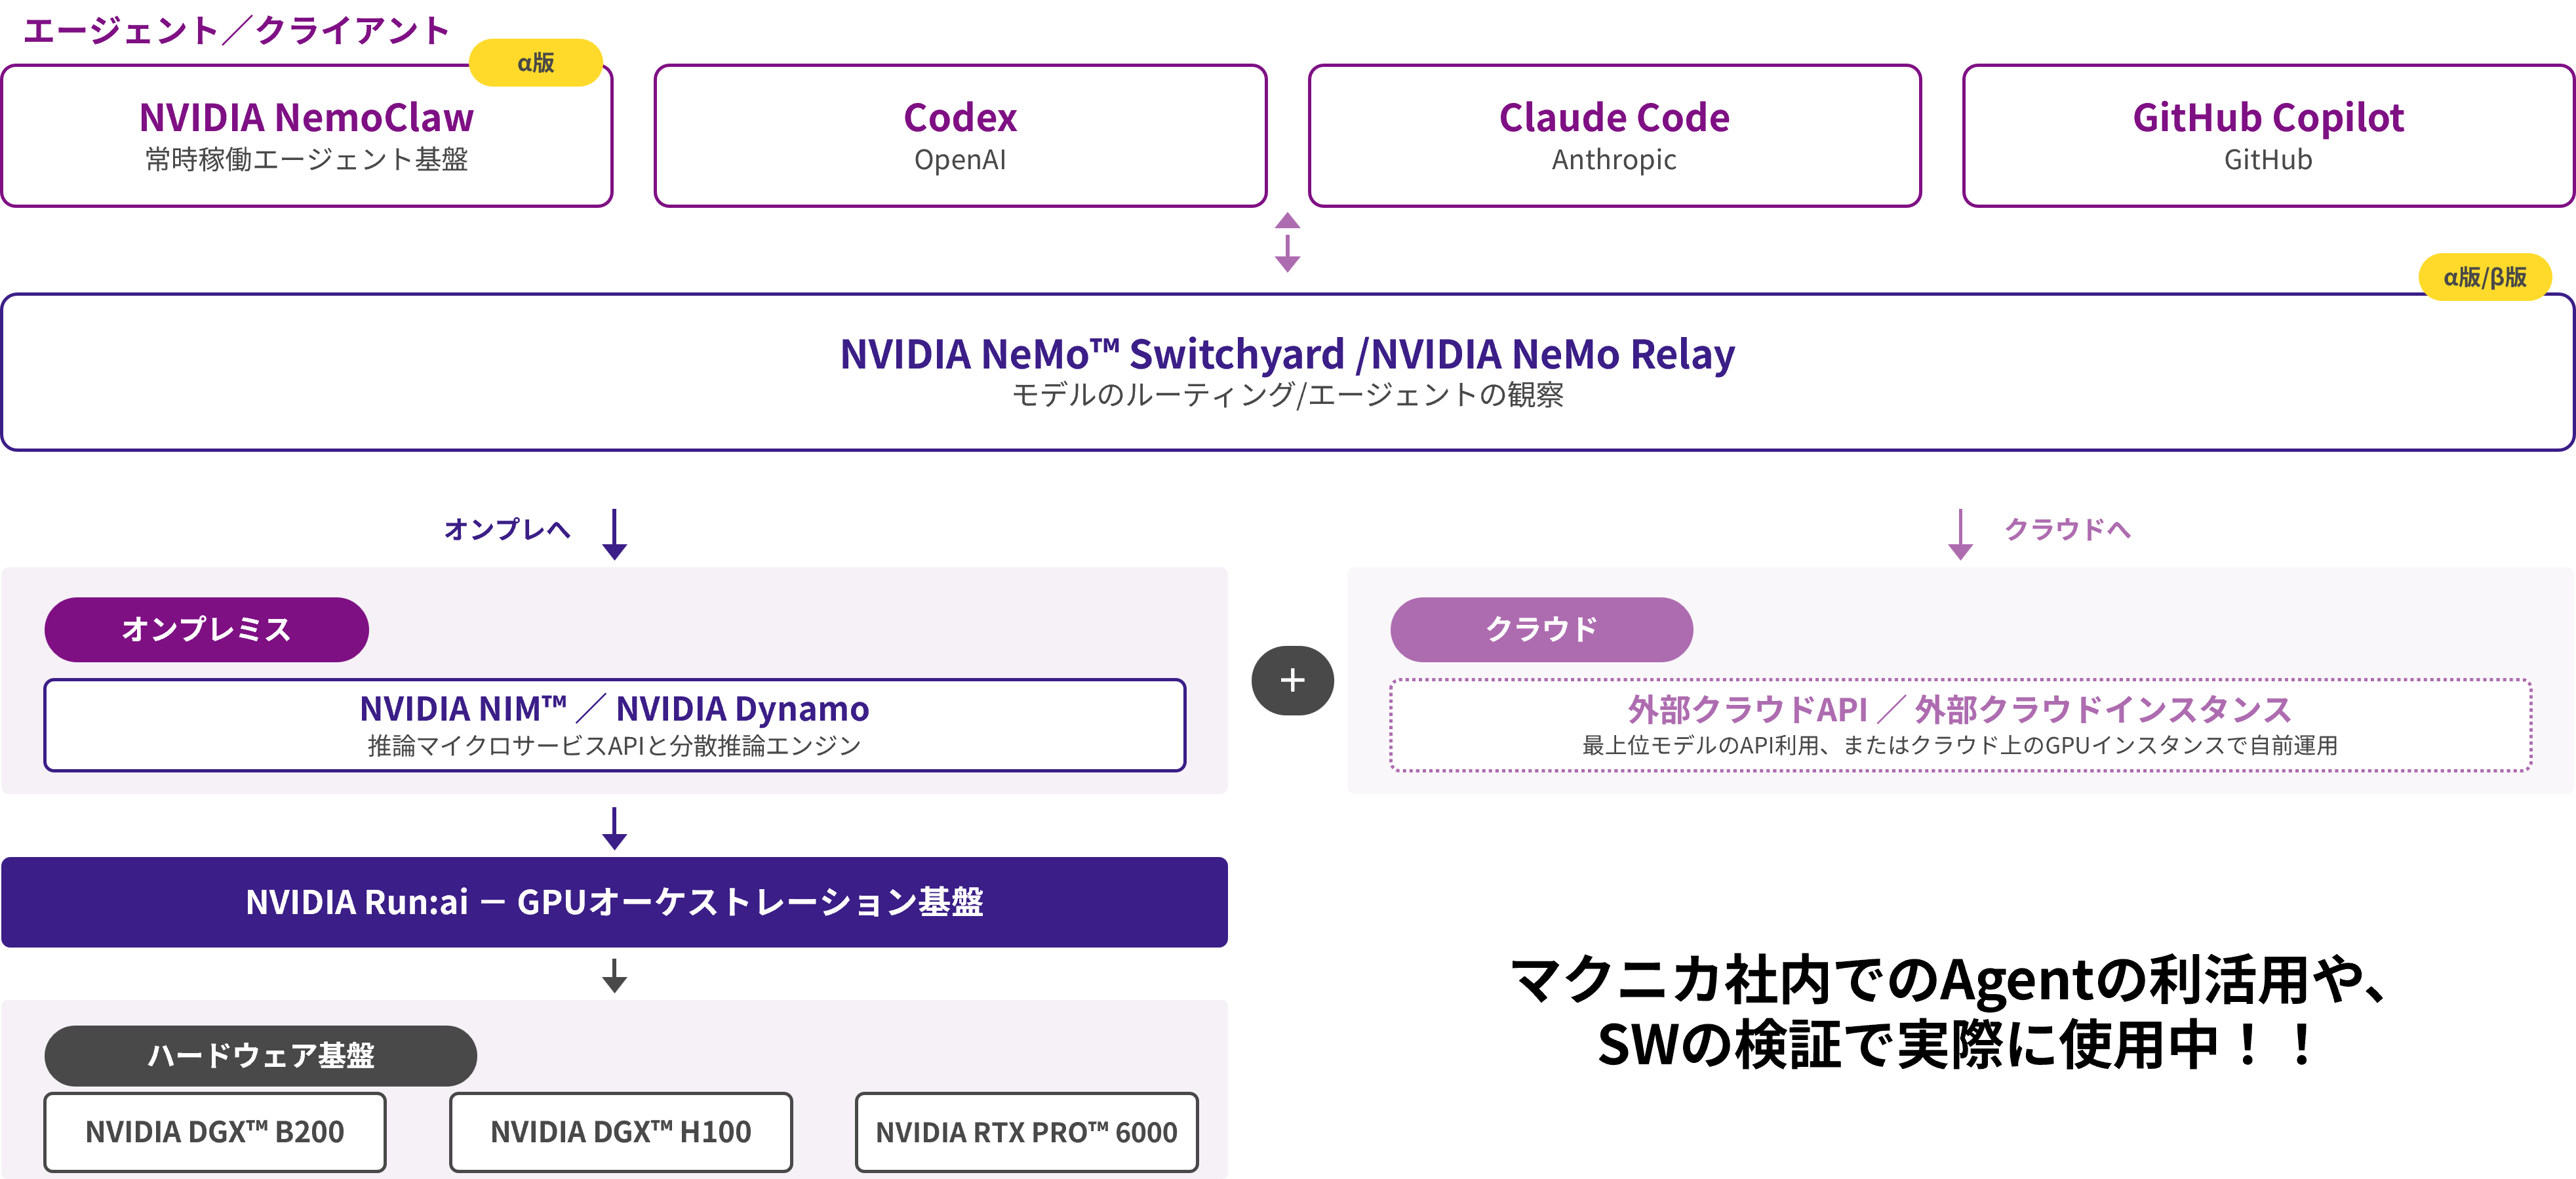
上図は、部門の検証環境の全体像です。今回の検証では、このうちDGX B200上でGLM-5.3-FlashのNVFP4版(nvidia/GLM-5.3-Flash-NVFP4)を動かし、オンプレミス側のモデルとして使っています。
あわせて、NVIDIA NeMo™ Switchyard[6][7] を使い、オンプレミスのモデルで対応しきれない場合にClaude(Opus 5.5)へエスカレーションする経路を用意しました。難しい判断の一部だけをフロンティアモデルに回す方式は、NVIDIAの技術ブログ [6] やLangChainの検証 [8] でも有効性が示されています。
クライアントには、Claude Code / GitHub Copilot / Codexを従来どおり使えます。利用者は、接続先のモデルが変わったことをほとんど意識せずに済みます。
日常業務でハイブリッド推論環境を使ってみる:411リクエスト中402件 がオンプレミスで完結
チームへ展開する前に、まず私自身がコーディングや資料作成などの日常業務でこの環境を試しました。この試行でのリクエストの大半は、コードの作成・修正やエラー調査などの開発業務でした。
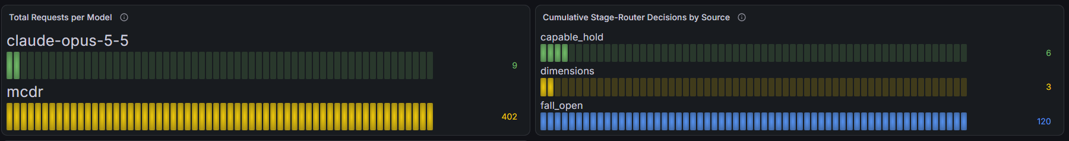
上図は、実際に運用しているダッシュボード(Grafana)の画面です。左のパネルはモデル別のリクエスト数で、[mcdr] がオンプレミスのGLM-5.3-Flash、[claude-opus-5-5]がOpus 5.5を表します。411リクエストのうち402件をGLM-5.3-Flashが処理し、Opus 5.5へのエスカレーションは9件(約2%)でした。右のパネルは、ルーティング判定の内訳です。411件には、会話タイトルの生成などの補助的な処理も含まれます。これらは判定を経ずに直接GLMへ送られます。判定の対象になったのは129件で、そのうち120件は、判定が確定しない場合の既定動作としてGLMに送られました( fall_open )。Opus 5.5へのエスカレーションは9件で、判定対象の7%にあたります。内訳は、作業の停滞を示すスコアによる昇格が3回( dimensions )、昇格直後のターンでOpusを維持したものが6件( capable_hold )です。
少なくとも私の業務では、フロンティアモデルが必要になった場面はごく一部でした。エスカレーションは、タスクの難易度を見て判断されたわけではなく、ツールの実行でエスカレーションが必要なエラーが発生したかどうかで決まっています。この結果から、大半のタスクはオンプレミスで賄えると判断し、チームへの展開を決めました。
ルーティングの効果については、公開情報として次のような事例もあります。LangChainがSwitchyardを145件のマルチターン・エージェントタスクで評価した結果では、フロンティアモデルが必要だったのは全ターンの7%で、残りの93%は30B級のモデルが処理しました [8]。コストは74%削減された一方、精度は約6ポイント低下しています。こうした評価では、フロンティアモデルへの呼び出しは回数こそ7%でも、コストの68%を占めるという報告もあります [6][8]。呼び出し回数の少ない難所にコストが集中する構造のため、日常業務を安価なモデルに寄せるだけで、コスト削減の効果が大きく現れることを示しています。また、NVIDIAの技術ブログでは、CognitionがSwitchyardのルーティングをDevin Desktopに組み込み、すべてをフロンティアモデルで処理する場合と比べて平均コストを28%削減しつつ、ほぼ同等の性能を維持した事例が紹介されています [6]。
チームへの展開:約30名での運用
展開はソフトウェアエンジニアから始め、その後、資料作成が主業務のメンバーを含むチーム全体(約30名)に広げました。
|
項目 |
実績 |
|
利用者数 |
約30名 |
|
リクエスト数 |
約4,300リクエスト/日(年間約102.7万件換算※) |
|
資料作成・壁打ち |
約30名(エンジニア以外を含む大多数が日々利用) |
|
コード生成・デバッグ |
約10〜15名 |
※直近8営業日の平均(約4,280リクエスト/日)を年間240営業日で換算しています。
利用状況で最も多い用途はコーディングではなく、資料作成と壁打ちです。ソフトウェアエンジニア以外のメンバーを含め、ほぼ全員が日常的に利用しています。AIエージェントの用途はソフトウェア開発に限らないことが、実際の利用状況から確認できました。
約30名が日常的に使うようになると、次に気になるのは、複数人が同時に利用しても応答速度を維持できるか、そしてこの環境の投資を回収できるか、の2点です。
第2話では、この2点を公開ベンチマークと実運用データを用いて検証します。
まとめ
本記事では、オープンウェイトのLLMの性能向上を受けて社内にオンプレミス環境を構築し、チームに展開するまでの経緯を紹介しました。まず私の日常業務で試したところ、411リクエストのうち402件(約98%)をオンプレミスのGLM-5.3-Flashで処理し、Opus 5.5へのエスカレーションは9件にとどまりました。フロンティアモデルが必要な場面は残るものの、その出番はごく一部です。この結果をもとに、オンプレミス環境をチーム全体(約30名)に展開し、現在も運用しています。
第2話では、このサーバが何人分のエージェントを支えられるのかを公開ベンチマークで定量的に測定したうえで、初期投資を約1億円と仮定した時に何名の利用で元を取れるのかを、実運用データから試算します。
引用文献
- [1] Z.ai, “zai-org/GLM-5.3-Flash”(Hugging Face モデルカード)
- [2] NVIDIA, “nvidia/GLM-5.3-Flash-NVFP4”(Hugging Face モデルカード)
- [3] Artificial Analysis, “LLM Leaderboard — Comparison of AI Models”(Intelligence Index v4.3.2)
- [4] Artificial Analysis, “Claude Opus 4.8: API Provider Performance Benchmarking & Price Analysis”
- [5] マクニカ、「AI TRY NOW PROGRAM」で「NVIDIA DGX B200システム」を用いたAIエー ジェントとPhysical AI検証環境の提供を開始(2025年9月3日)
- [6] NVIDIA Technical Blog, “Route AI Agent Workloads Across Models with NVIDIA NeMo Switchyard” (2026年8月11日)
- [7] NVIDIA-NeMo, “Switchyard” (GitHub)
- [8] LangChain, “How many of your agent’s calls actually need a frontier model?”
お問い合わせ