- 半導体事業HOME
- マクニカの製品・サービス
-
技術情報

-
イベント・セミナー
- 取扱メーカー
- サポート
- お問い合わせ
- 製品購入はこちら
- 半導体事業のメルマガ登録


 条件を指定して絞り込む
現在2232件がヒットしています。check
本記事では、NVIDIAが公開しているNVIDIA Cosmos™ 3のRobot Policy向けポストトレーニングレシピを参考に、自前で収集したSO-ARMロボットの操作データを用いてCosmos3 Nanoを追加学習し、SO-ARM向けのRobot Policyを作成した取り組みを紹介します。
なお、本記事では実装や学習設定の詳細な解説ではなく、Cosmos 3とは何か、Robot Policyとは何か、そして独自ロボット向けRobot Policyの作成から実機適用までの全体像を理解することを目的としています。
NVIDIA Cosmos 3とは
Cosmos 3は、NVIDIAが公開したPhysical AI向けの基盤モデルです。一般的な生成AIは文章や画像を生成することが主な用途ですが、Cosmos 3 は、画像・動画・音声・アクション(行動)など複数の情報まで統合して扱うことができます。
そのため、Cosmos 3はさまざまなPhysical AIアプリケーションの基盤として活用できます。
・画像や動画を理解するモデル
・ロボットを動かすモデル(Robot Policy)
・将来の状態を予測するモデル
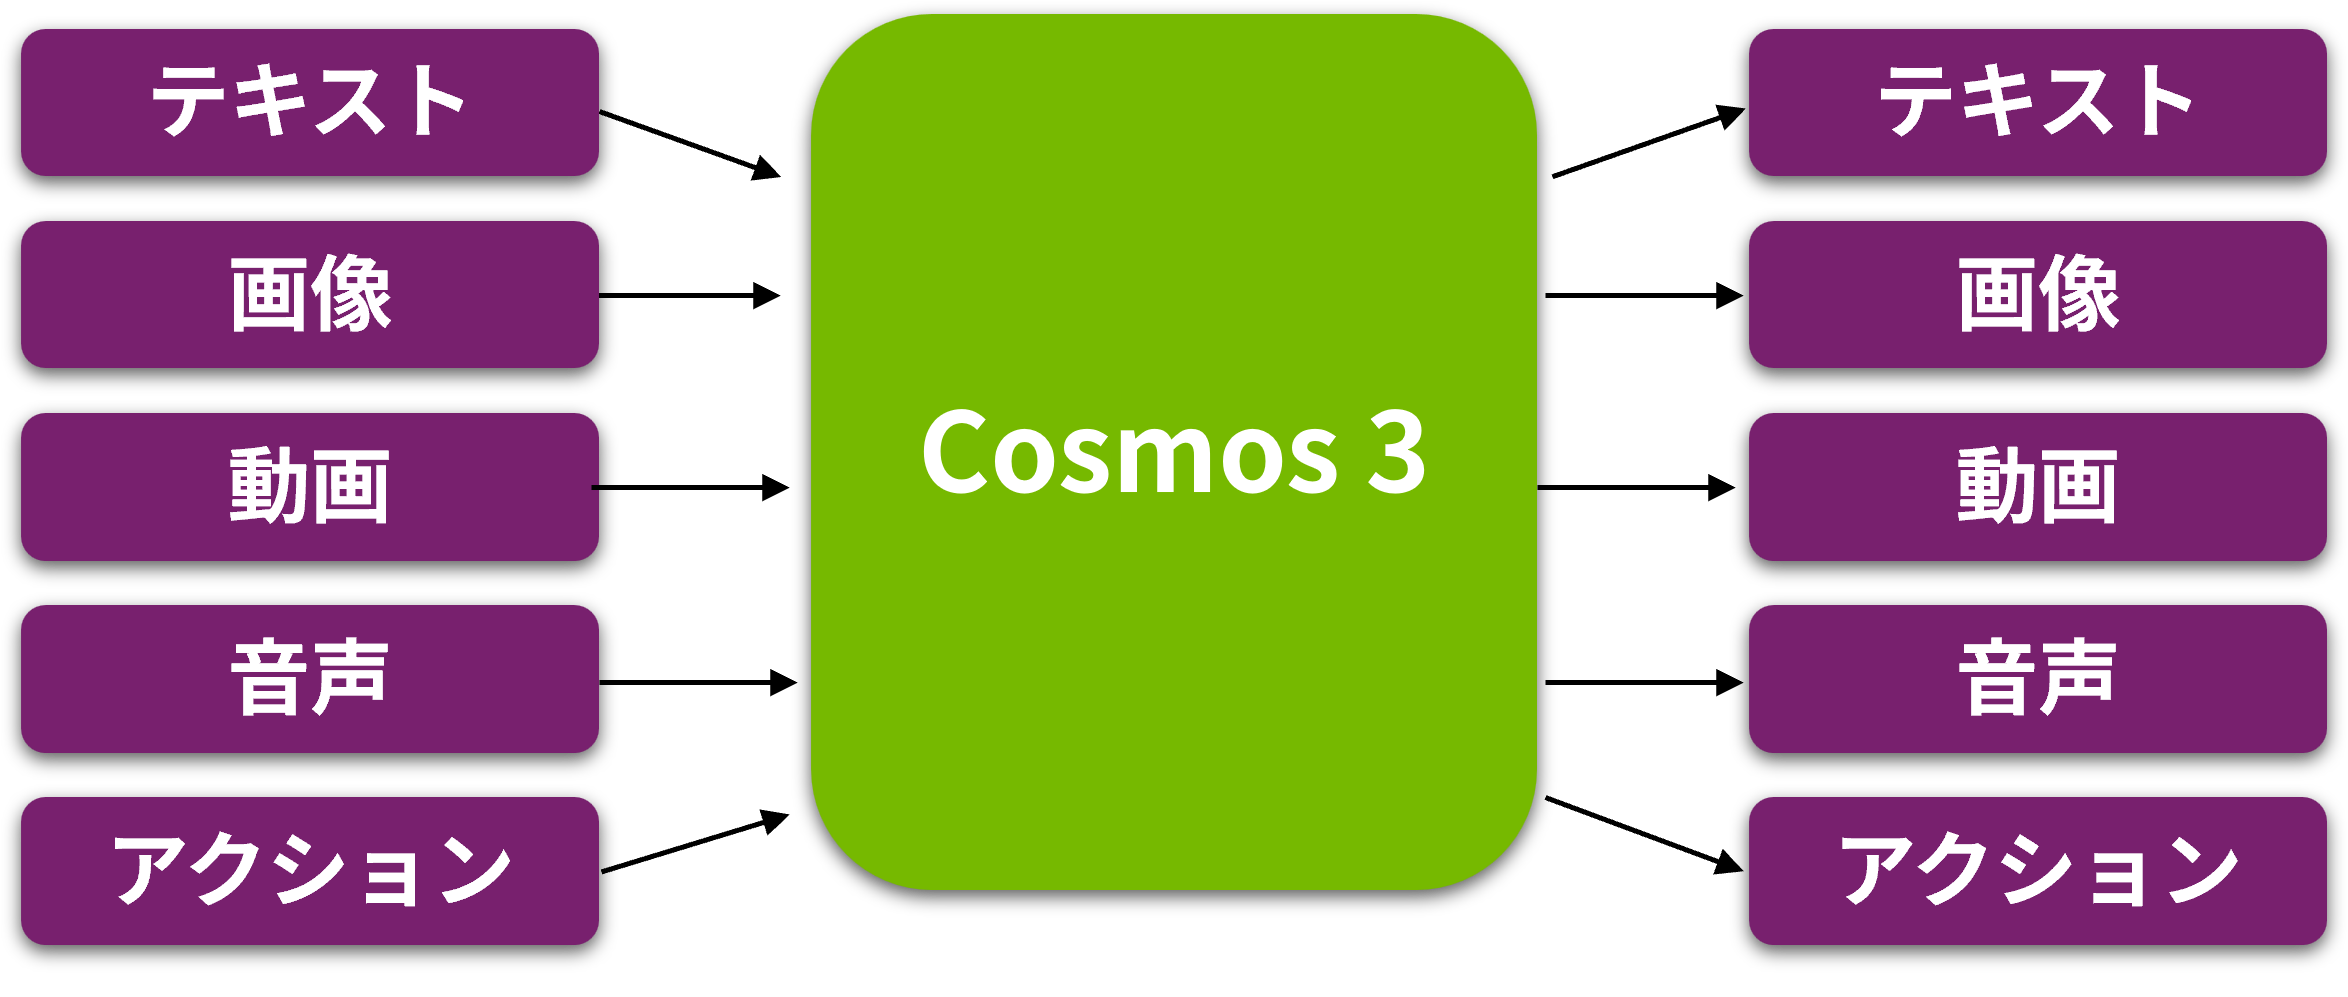
Cosmos 3の大きな特長は、現在の世界の状態を理解するだけでなく、「次に何が起こるか」を予測できる点です。この予測能力により、ロボット制御や自動運転など、現実世界で行動するPhysical AIとの親和性が高い基盤モデルとなっています。
今回扱う Robot Policy は、ロボット制御向けに特化したモデルです。特定のロボットから収集した画像、現在の関節状態、操作指示、実際の動作を学習させることで、そのロボット適したRobot Policyを作成できます。Cosmos 3を用途に合ったデータでポストトレーニング(追加学習)することで、専用の派生モデルを構築できます。
Cosmos 3は、「未来を予測できるPhysical AIの土台」であり、Robot Policyはその土台から作られるロボット制御向けの特化モデルです。
参考:Cosmos 3
Cosmos 3 のRobot Policyとは
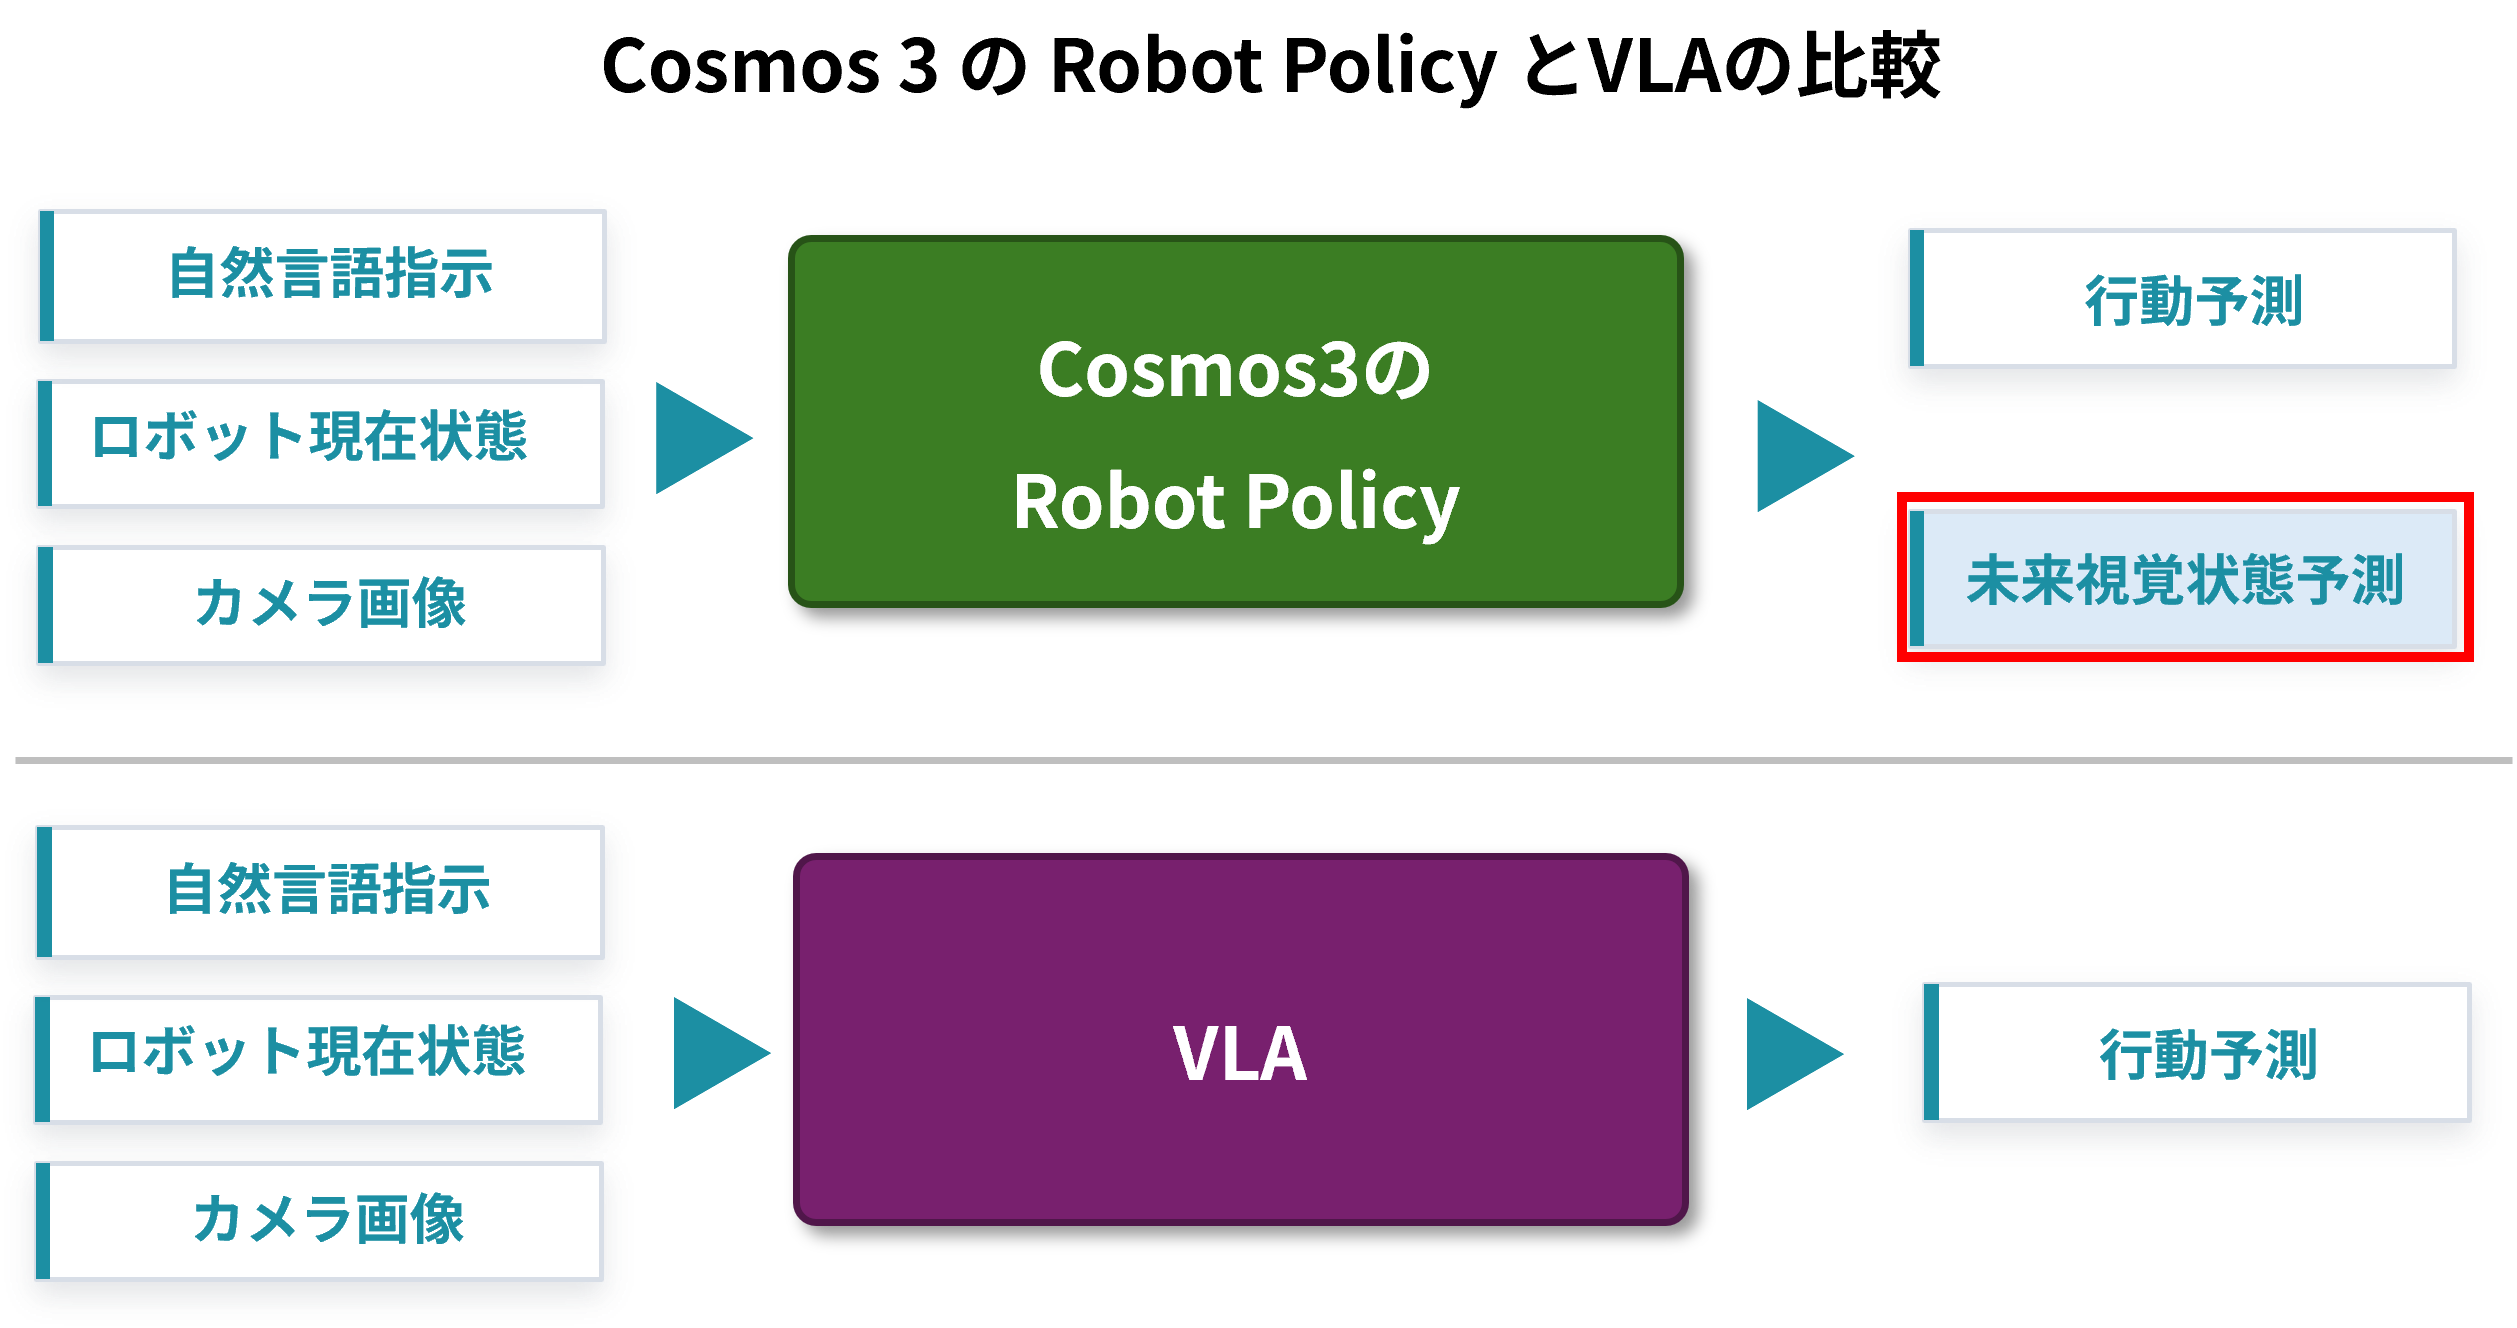
ロボット制御AIとしては、近年 VLA(Vision-Language-Action)が広く利用されています。VLAは、画像と言語指示からロボットの動作を直接生成するモデルです。
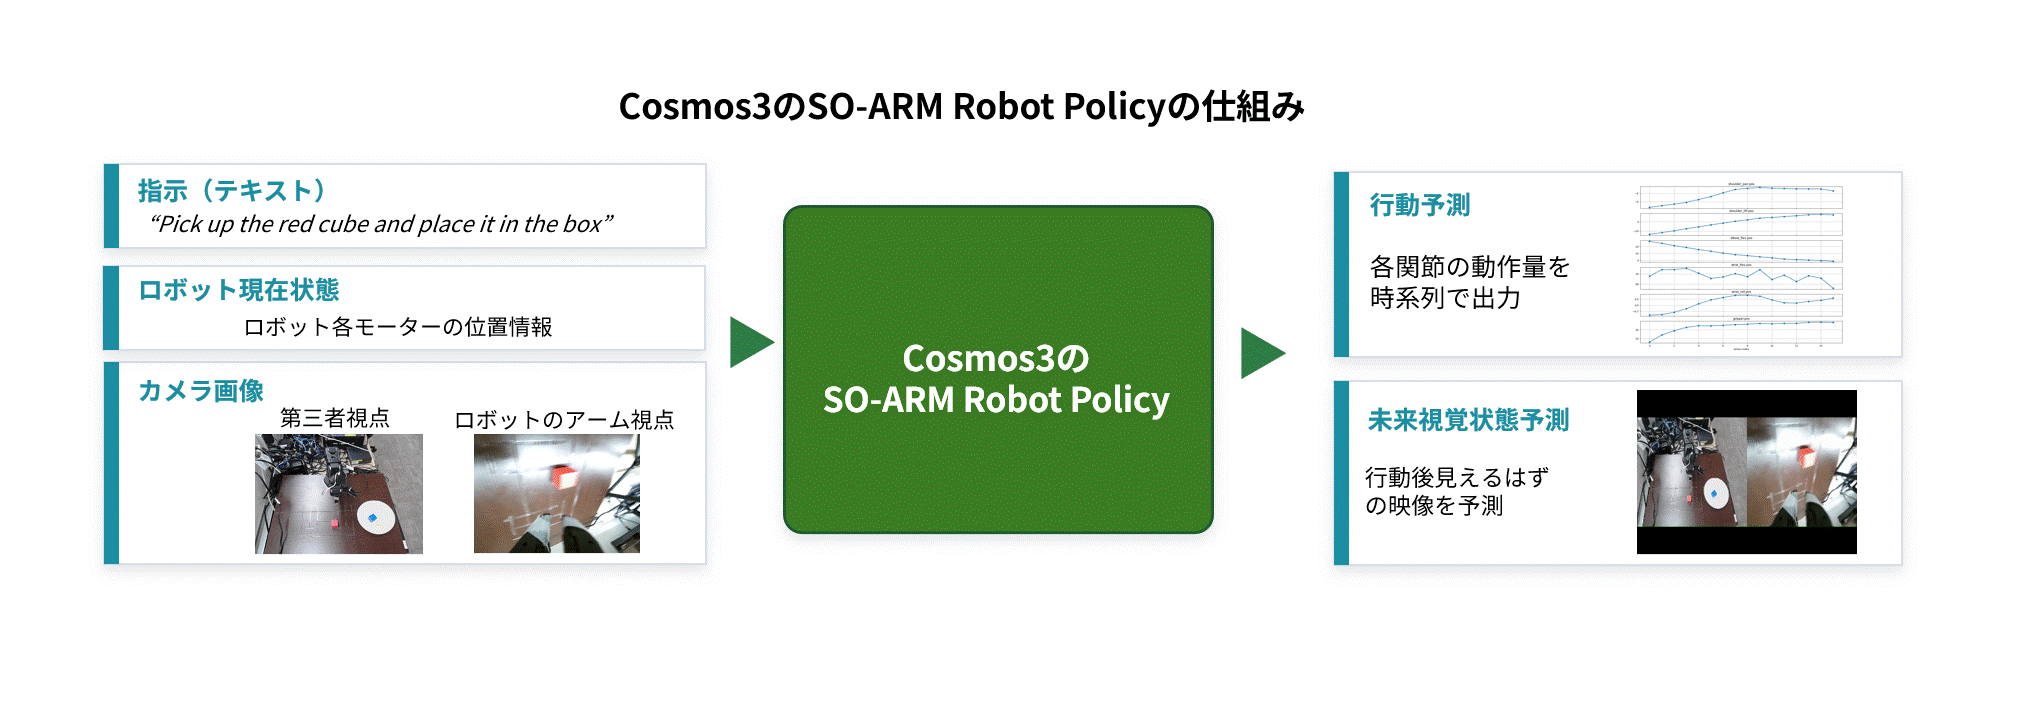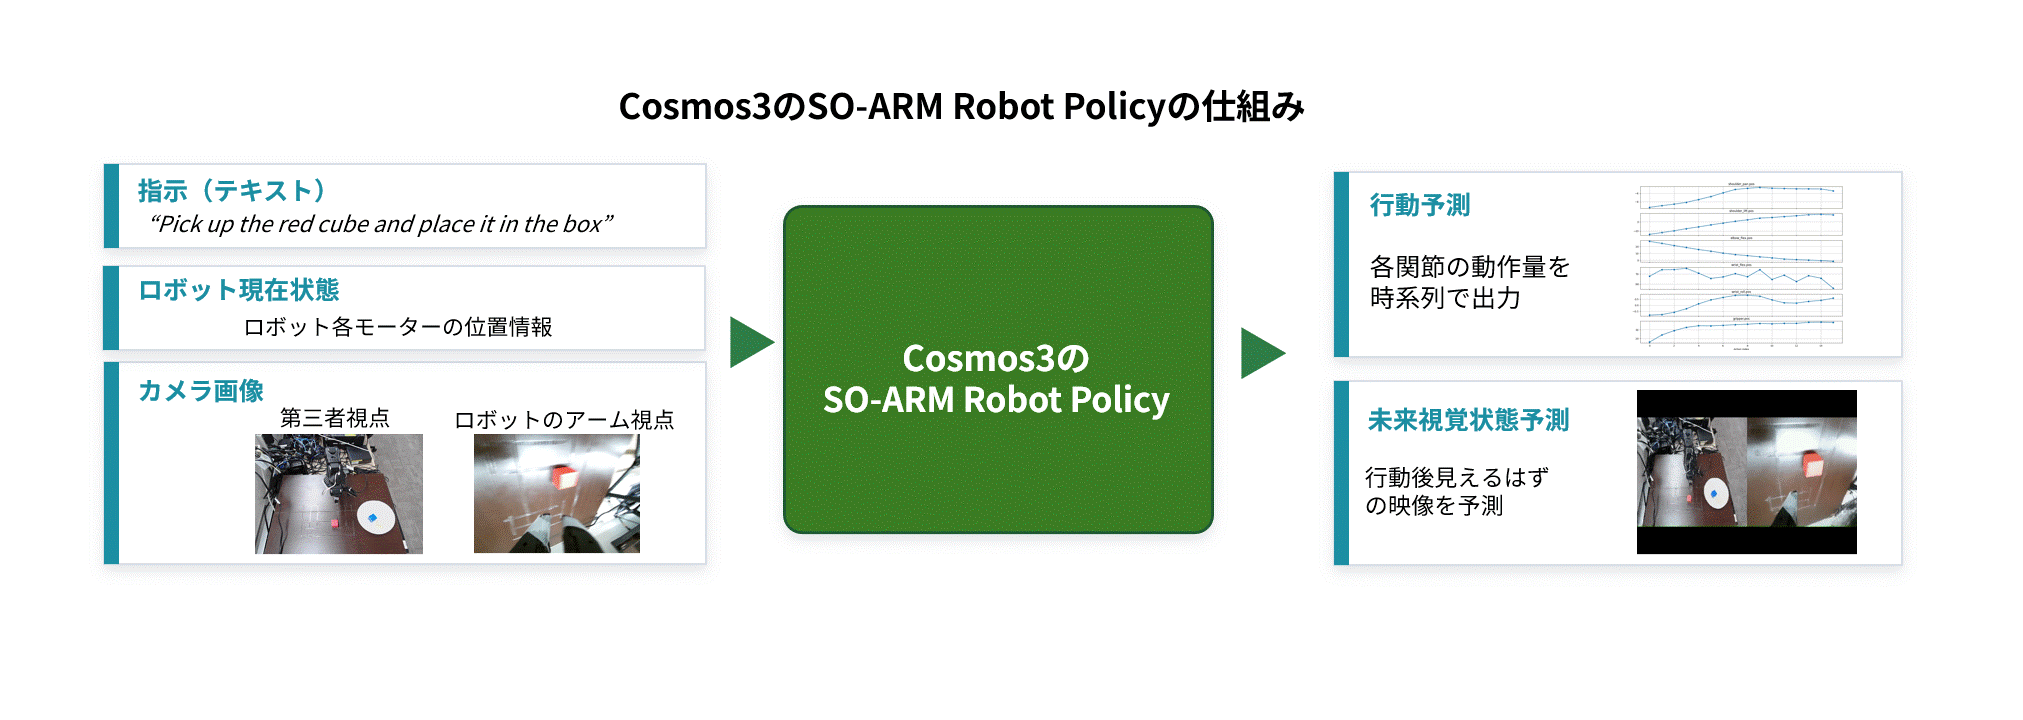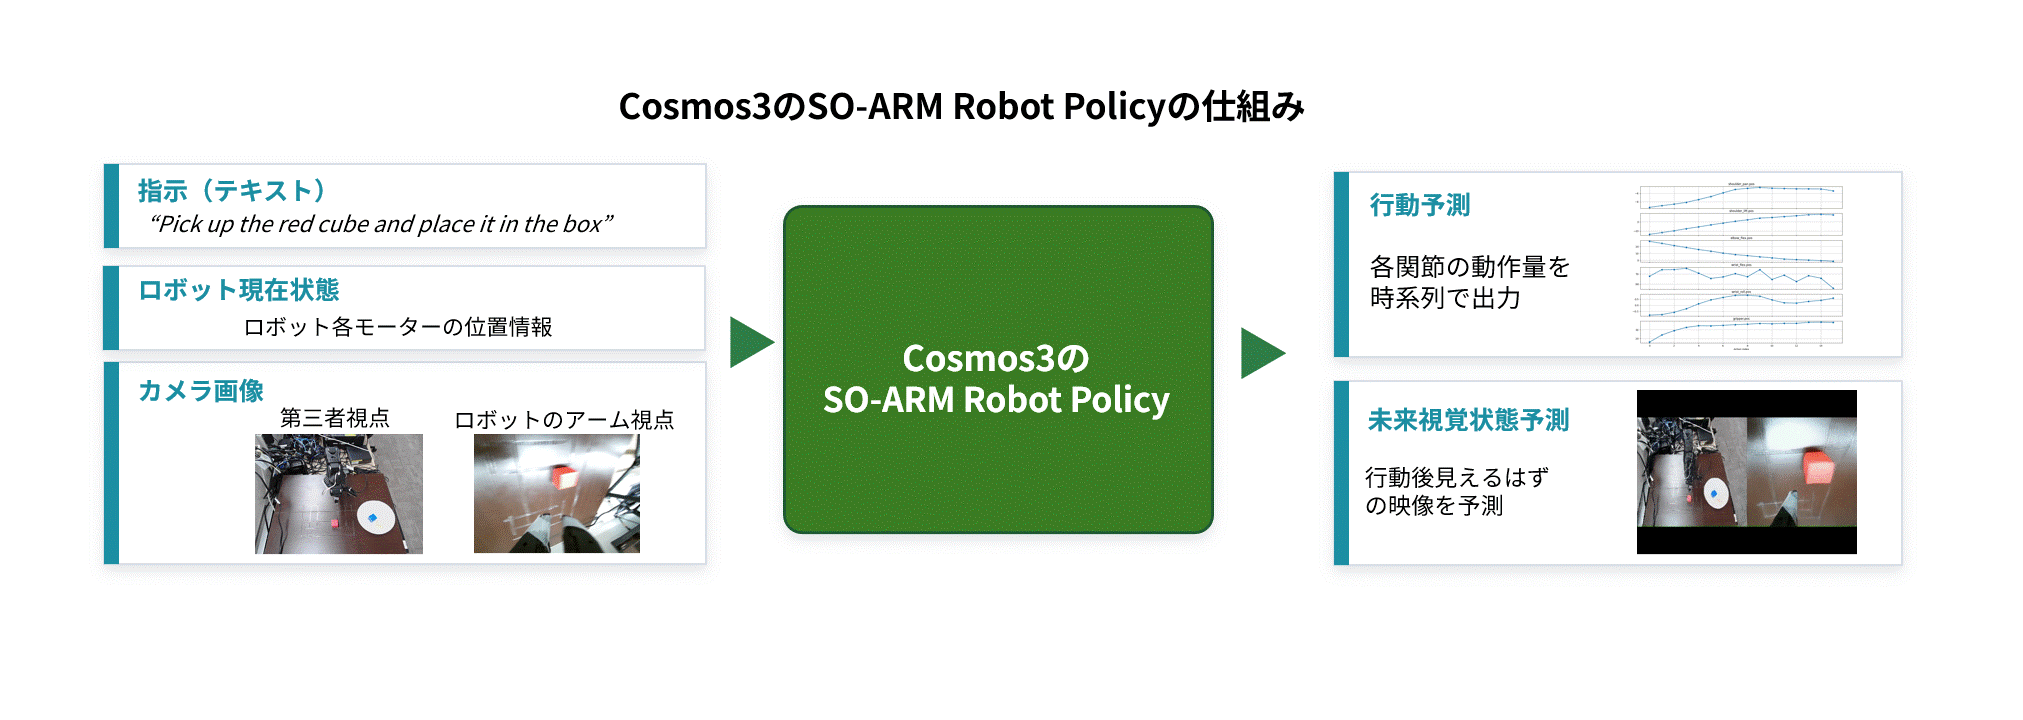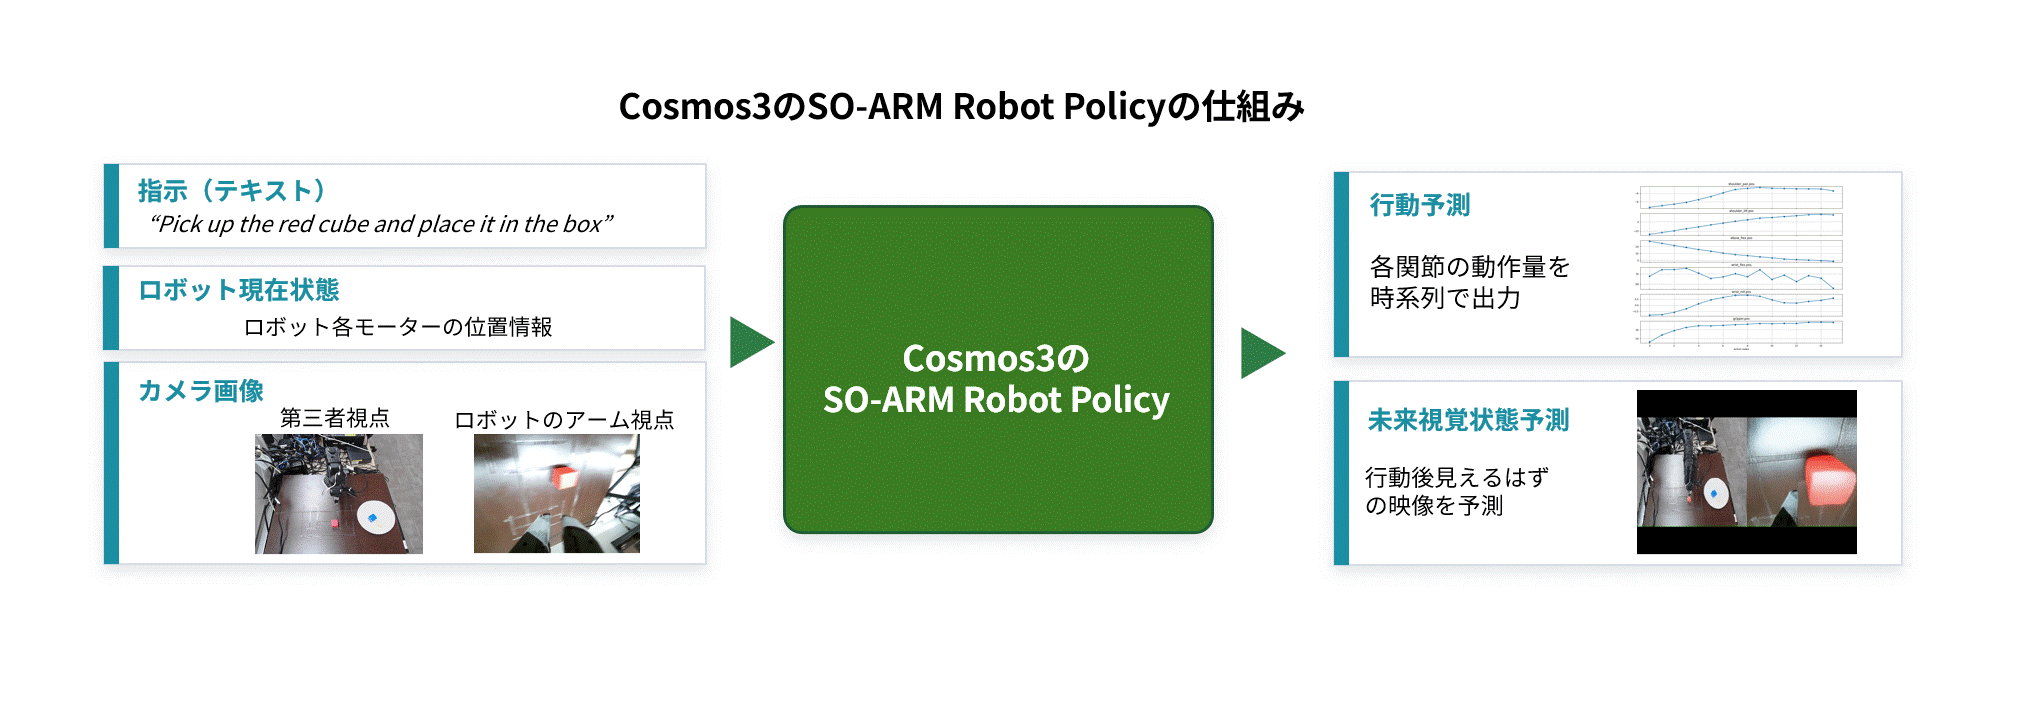
一方、Cosmos 3 のRobot Policyは単に行動を生成するだけではありません。ロボットの状態、言葉の指示から動作を予測します。さらに、動いた後に周囲の見え方がどう変化するかという「未来の視覚状態」も同時に予測できる点が特長です。
つまり、VLAが「今の状況から次の動作を決める」モデルであるのに対し、Cosmos 3 のRobot Policyは「動作と一緒に動きにより世界がどう変わるか」をセットで予測するモデルです。このように、未来の状態と行動を同時に扱うモデルはWorld Action Model(WAM)と呼ばれます。
Cosmos 3 のRobot Policyは、ロボットの動作だけでなく「その動作によって世界がどう変化するか」まで同時に予測できるモデルです。
Cosmos 3のモデルラインアップ
Cosmos 3には、用途や実行環境に応じて複数のモデルサイズが用意されています。モデルが大きいほど高い性能が期待できますが、学習や推論に必要なGPU資源も増えます。
|
モデル |
サイズ |
特長 |
主な用途 |
|
Cosmos 3 Super |
64B |
最も高性能なモデル |
高精度な合成データ生成 |
|
Cosmos 3 Nano |
16B |
バランスが良いモデル |
速度と品質をバランスよく ロボット制御、動画理解、 合成データ生成 |
|
Cosmos 3 Edge |
4B |
軽量モデル |
エッジデバイス上での推論、 ロボット組み込み用途 |
今回の検証ではCosmos 3 Nanoを採用しました。検証時点で公開されていたRobot Policy向けポストトレーニングレシピと実機動作を確認することを目的としたためです。なお、現在はNanoより軽量なCosmos 3 Edgeもラインアップに加わっています。
検証概要
今回の検証では、NVIDIAが公開しているRobot Policy向けのポストトレーニングレシピを参考に、自前で収集したSO-ARMの操作データを用いてRobot Policyを作成し、実機ロボットでの動作検証を行いました。
本検証の目的は、公開されているレシピを利用してRobot Policyを構築するとともに、ポストトレーニングによって生成したRobot Policyが実際のロボット制御に利用できることを確認することです。
また、Robot Policyは特定のロボット専用のモデルではありません。Cosmos 3をベースに、それぞれのロボットの操作データを用いてポストトレーニングを行うことで、異なるロボット向けのRobot Policyを構築できます。今回はSO-ARM向けのRobot Policyを作成しましたが、同様のアプローチを用いることで他のロボットへの適用も期待できます。
データセット
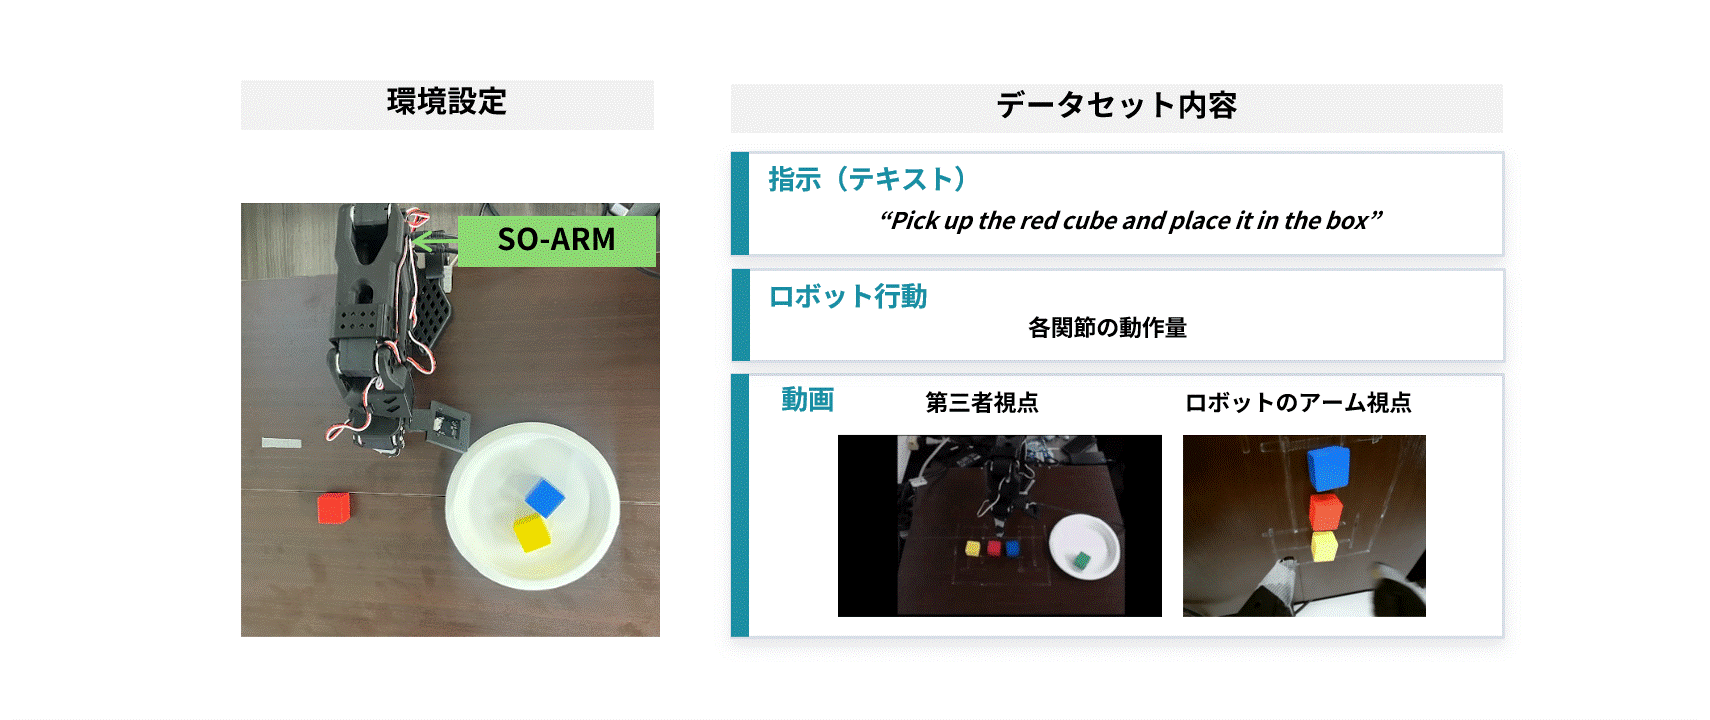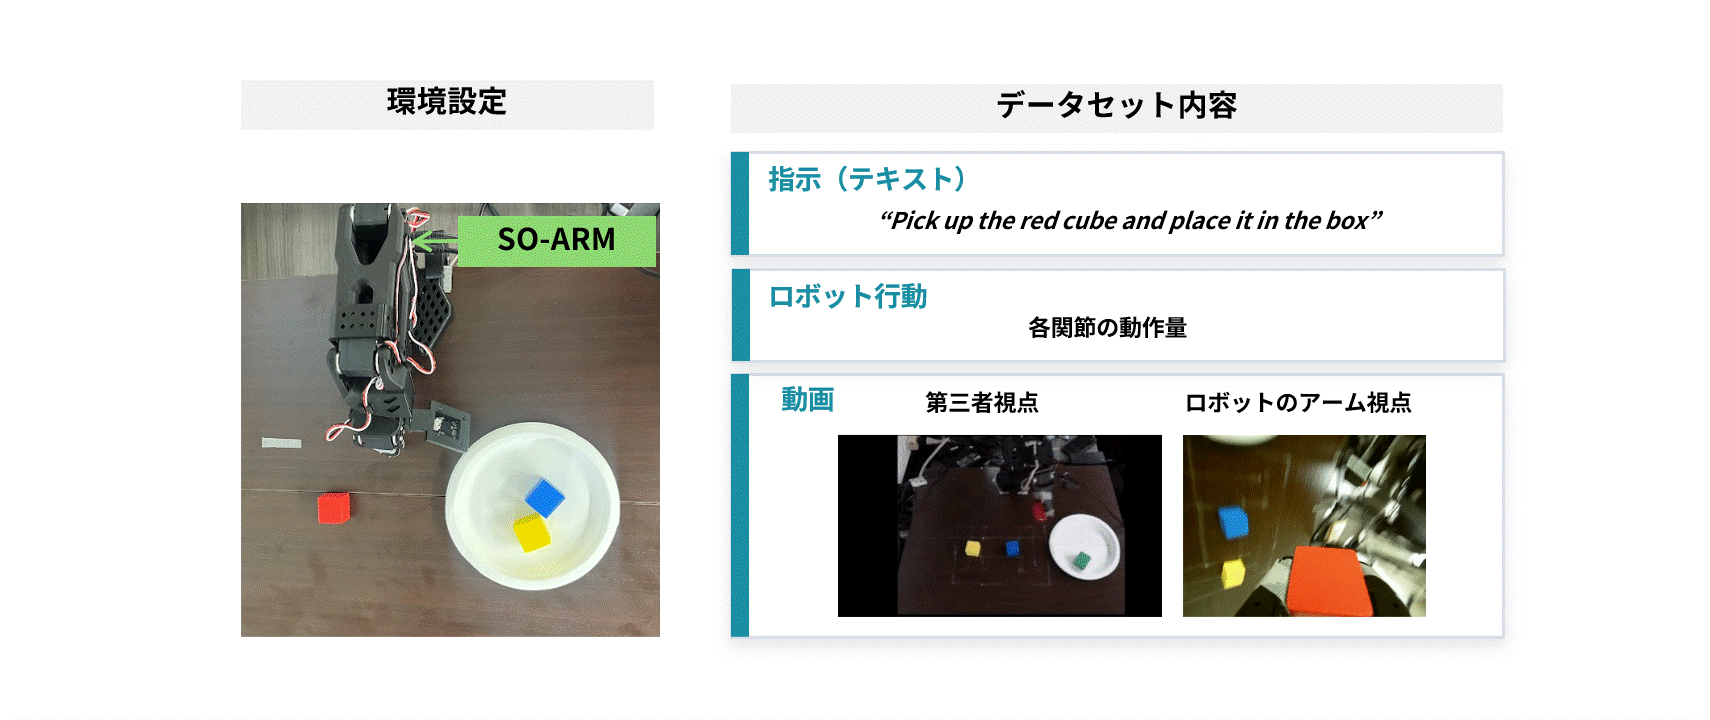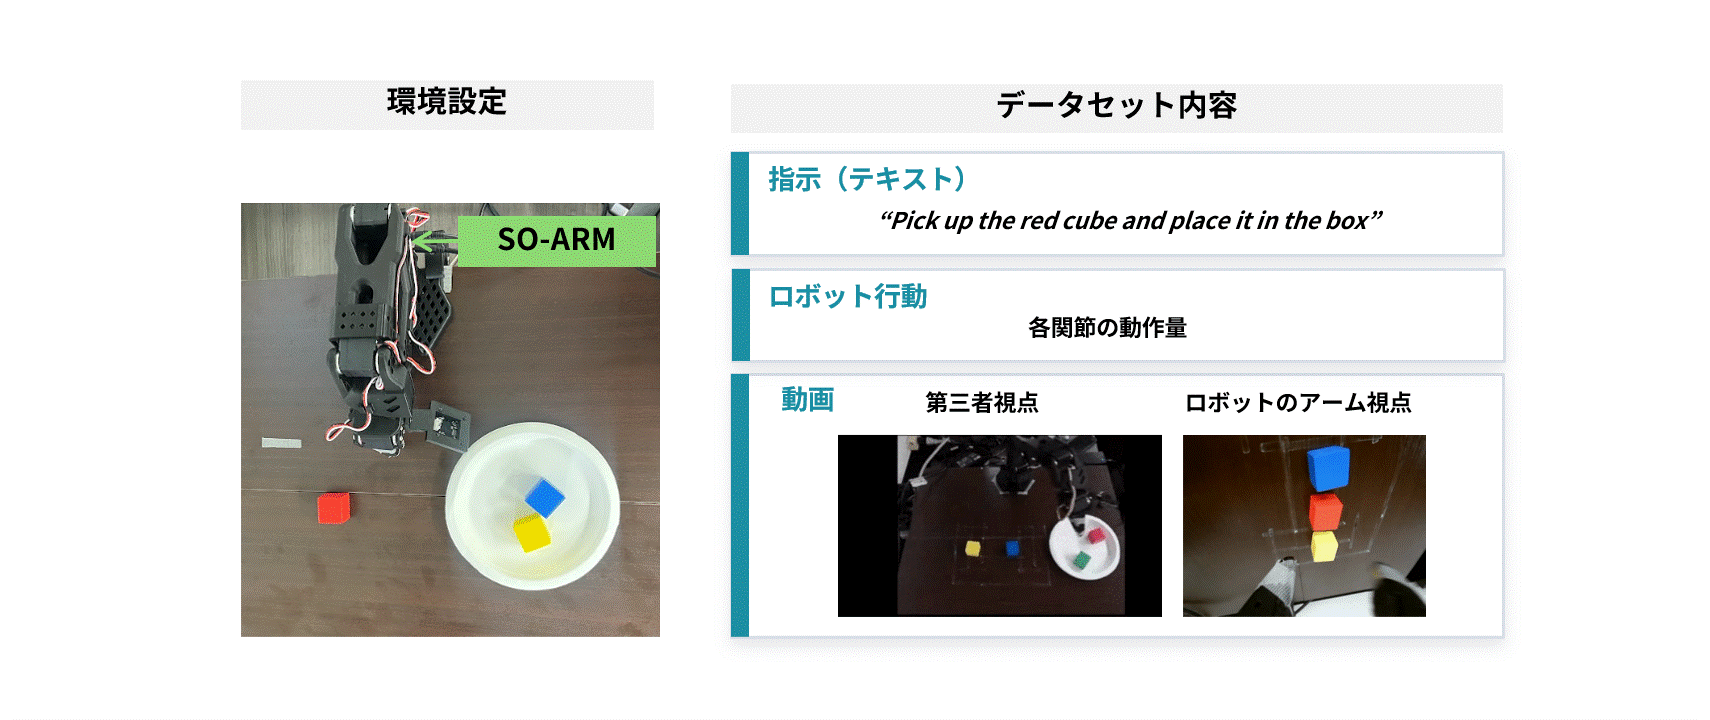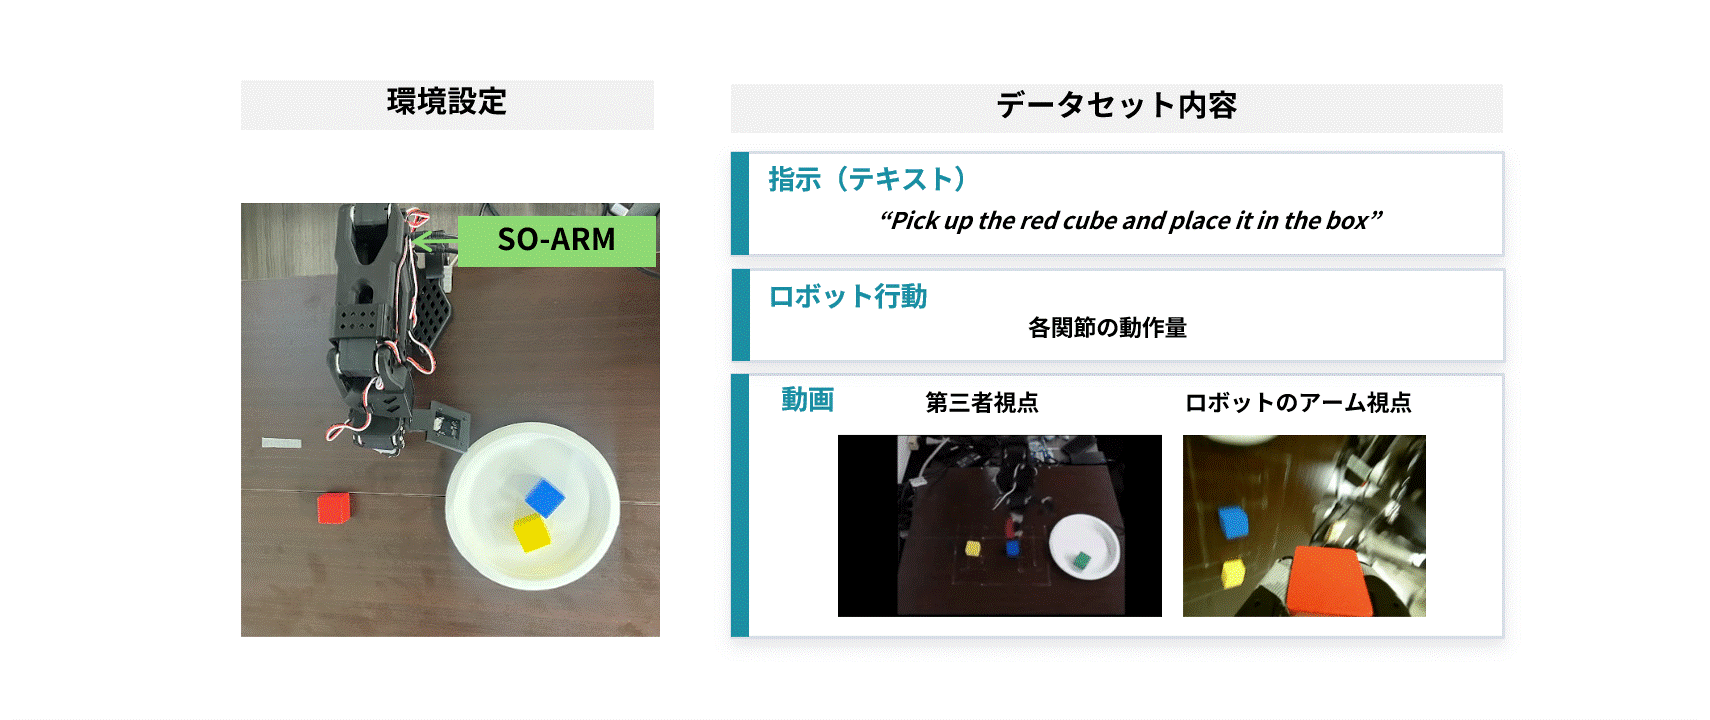
学習タスクには、指定された色のキューブを掴み、指定位置へ移動させる Pick & Dropタスクを使用しました。SO-ARMを操作して、132エピソード分のデータを収集し。各エピソードには、作業指示、2視点のカメラ映像、ロボットの関節状態、実際に行った動作が含まれます。
検証環境
|
項目 |
内容 |
|
OS |
Ubuntu 24.04 |
|
GPU |
NVIDIA GB200 NVL72(KDDI提供環境) |
|
モデル |
nvidia/Cosmos3-Nano |
今回の検証では、KDDI GPU Cloud上の NVIDIA GB200 環境を利用しました。GB200は大規模AIモデルの学習にも実施でき、非常に高性能なGPUです。
参考:KDDI GPU Cloud
ポストトレーニング・デプロイ
Cosmos 3-NanoをSO-ARMで利用するため、収集したデータを使ってポストトレーニングを行いました。学習設定にはSO-ARMの関節数、カメラ構成、出力するアクションの形式などを反映しました。学習後は作成されたチェックポイントをRobot Policyサーバーへ配置し、実機側のクライアントから画像とロボット状態を送信できる構成にしました。
参考:cosmos-framework/ action_policy_libero_posttrain
cosmos-framework/action_policy_droid_posttrain
実機での推論とロボット制御
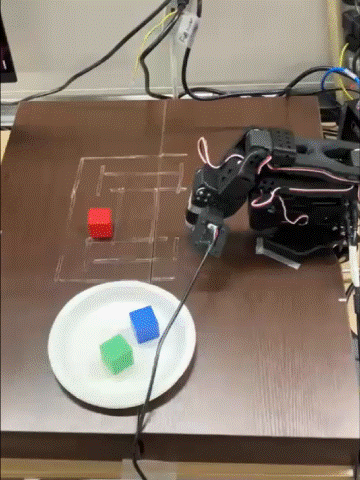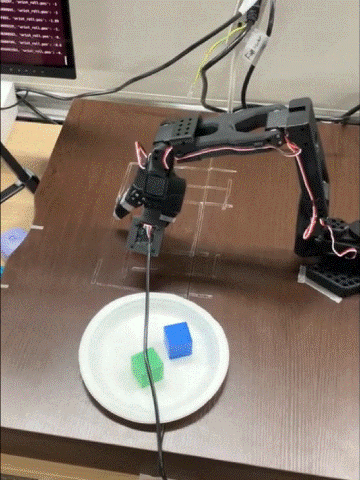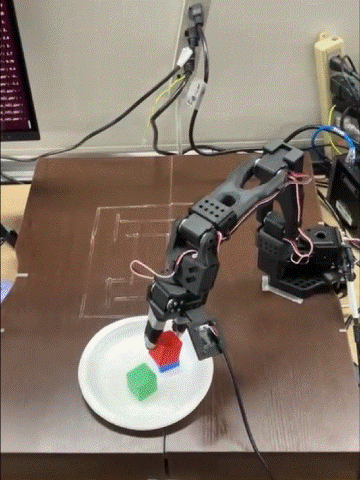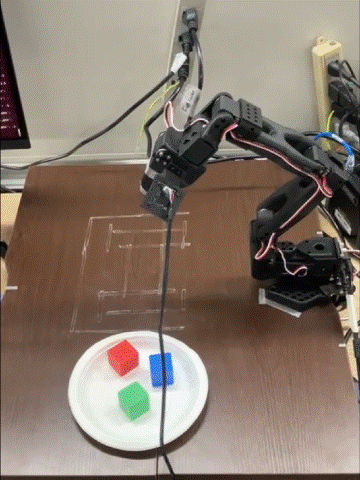
実行時は、SO-ARM側から現在のカメラ画像、関節状態、言葉の指示をRobot Policy サーバーへ送ります。Robot Policyが予測した関節動作をSO-ARMへ返すことで、実機を制御します。
予測した行動をSO-ARMロボットを動かす。
触ってみた感想
Cosmos 3 のRobot Policyを実際に試して特に興味深かったのは、単に次のアクションを予測するだけでなく、未来の視覚状態も同時に扱える点です。
この特性は、将来的に次のような活用へ広がる可能性があります。
・学習データの拡張
・実行前の状態変化やリスクの確認
今回の検証は、Cosmos 3を独自ロボット向けにポストトレーニングし、実機までつなげる一連の流れを確認する第一歩となりました。
まとめ
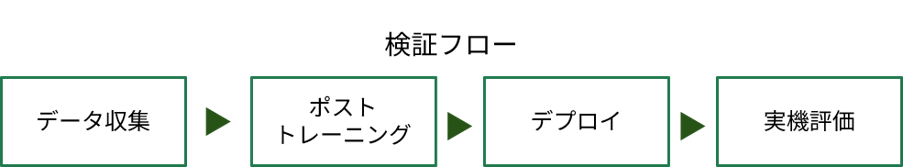
本記事では、Cosmos 3を活用したRobot Policy開発の全体像と、データ収集からポストトレーニング、デプロイ、実機評価までの概要を紹介しました。
ポイントは以下のとおりです。
・Cosmos 3は、Physical AI向けの基盤モデル
・Cosmos 3 のRobot Policyは、行動と未来の状態を同時に予測するWAM
・公開レシピを活用して独自Robot Policyを構築し、実機ロボットで動作を確認できた
本記事が、Cosmos 3を活用したRobot Policyの開発や、Physical AI向け学習環境の構築、実機ロボットへの適用を検討する際の参考になれば幸いです。
お問い合わせはこちら
Physical AIの導入をご検討中の方、学習環境の構築に関するご相談がございましたら、お気軽にお問い合わせください。