- 半導体事業HOME
- マクニカの製品・サービス
-
技術情報

-
イベント・セミナー
- 取扱メーカー
- サポート
- お問い合わせ
- 製品購入はこちら
- 半導体事業のメルマガ登録


 条件を指定して絞り込む
現在2228件がヒットしています。check
「AIエージェントを本格的に導入したい。どれくらいGPUは必要ですか?」
よく聞くテーマですが、なかなか答えづらい質問です。
次々に優秀なモデルがリリースされる一方で、最適化や推論高速化の技術も開発され、結局はGPUどれくらい必要なの?という状態です。エージェントに任せるタスクや利用者数によって必要なGPUは大きく変わるため、一概に「これだけあれば十分」とは言えません。そのため、GPU投資の判断に悩むケースも少なくありません。本記事では、「何人で利用するなら、どの程度のGPUがどのくらい必要なのか」という観点から、おおまかな目安をご紹介します。
なぜAIエージェントにGPUが必要なのか?
よく誤解されがちですが、エージェント自体はCPUで動作します。
GPUが必要になるのは、エージェントがループの中で「考える」を担当するLLMを実行する部分です。エージェントは自分で考えているわけではなく、考えるたびにLLMへ問い合わせを行っています。
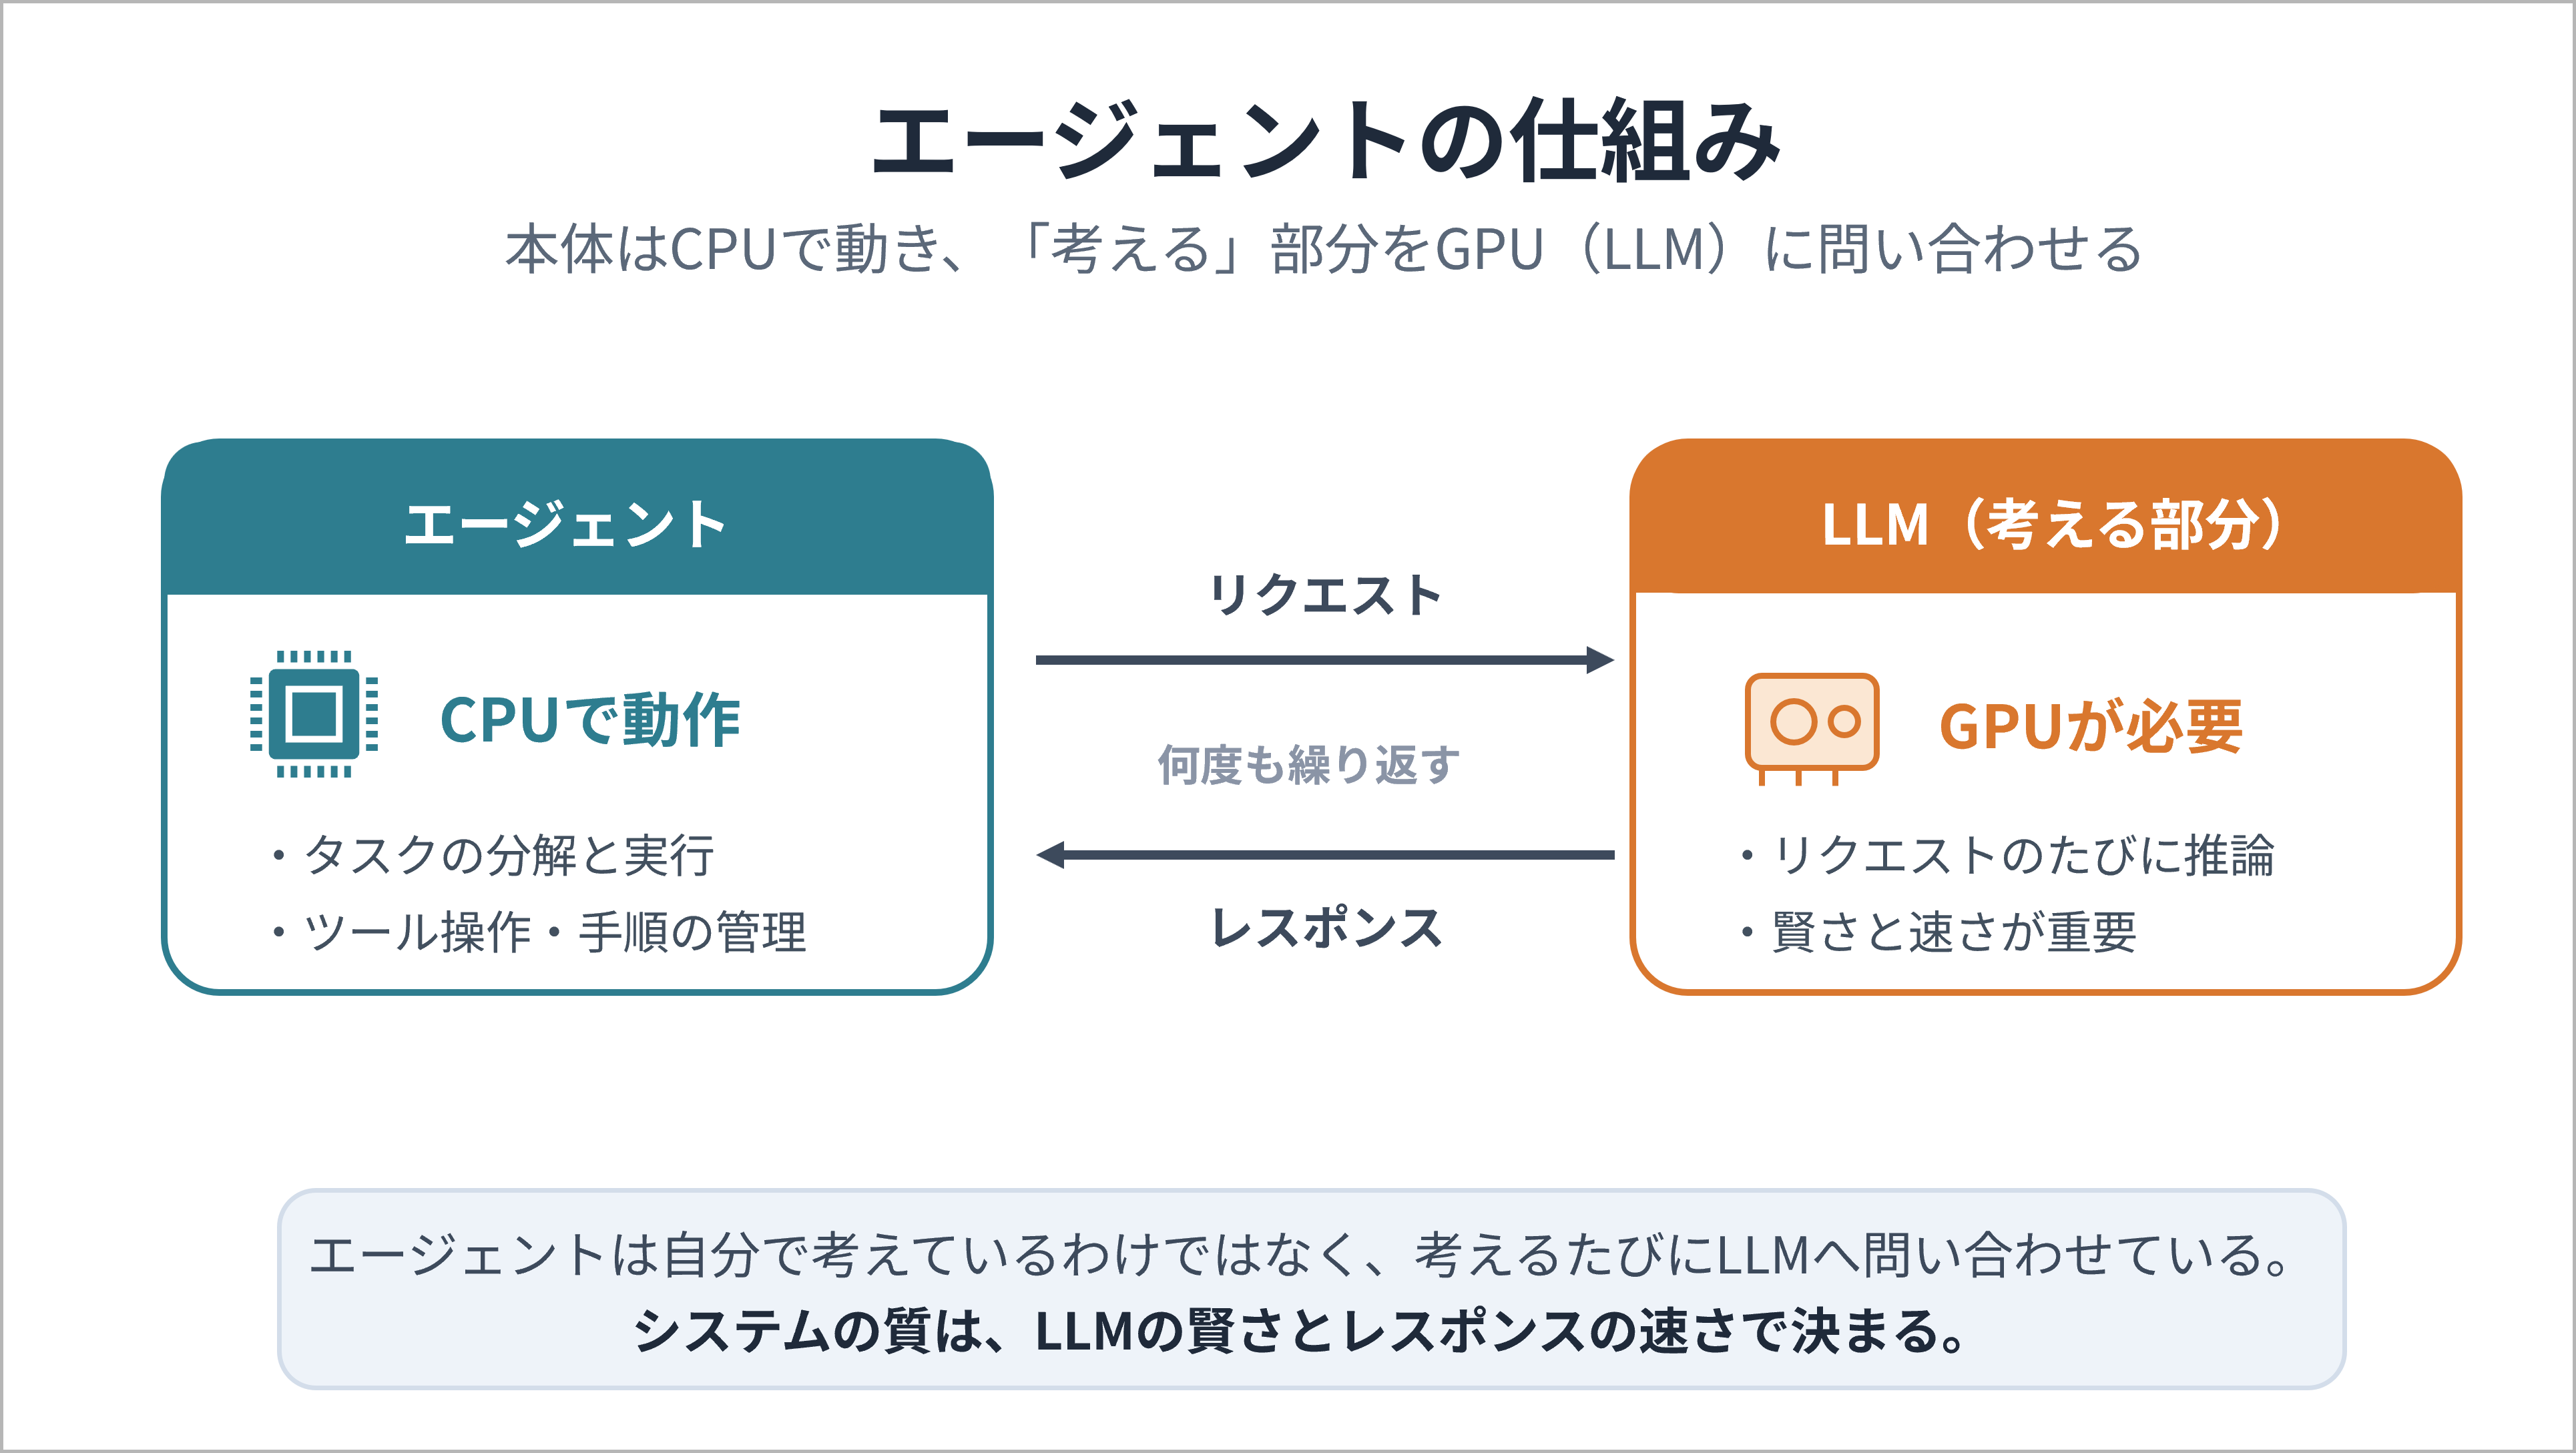
エージェント(ハーネス)の開発が進み、その影響ももちろん受けますが、エージェントシステム全体の品質を左右する要因の大半は、LLMの賢さとレスポンスの速さでほとんど決まってきます。
同時利用人数から考えるGPU必要量
今回は以下のケースを想定して、 ”利用人数ごと” に必要なGPUを考えてみます。
|
項目 |
説明 |
| モデル | nvidia/Kimi-K2.7-Code-NVFP4 |
| パラメーター数 | 総パラメーター1T、アクティブ32B |
| エージェントに依頼するタスク | コーディング、PDF・Webからのデータ収集 |
| 返答の速さの要求 | 体感で遅くない |
| 同時利用人数 | 1~100人 |
Kimi K2.7は、MoEアーキテクチャーを採用しており、総パラメーター数は多いものの、推論時に使われる重みは少なく、高速に動作できる特長を持っています。またNVIDIA社によるNVFP4と呼ばれる量子化をしたモデルを採用していることにより、GPUメモリーの使用量を抑えつつ、より高速に動作させることに特化しており、まさにエージェント向きのモデルと言えます。様々なベンチマークでも優秀な結果を残しており、個人的には商用モデルと遜色ない性能だと考えています。
返答の速さの要求は、”体感で遅くない”とアバウトに書いていますが、ここを数値化するのは非常に難しいです。よくある指標にtok/s(1秒間にどれくらいのトークンが生成できるか)がありますが、大体100tok/sあればレスポンスが速く感じる、というのが私の感覚です。
GPU必要量の考え方
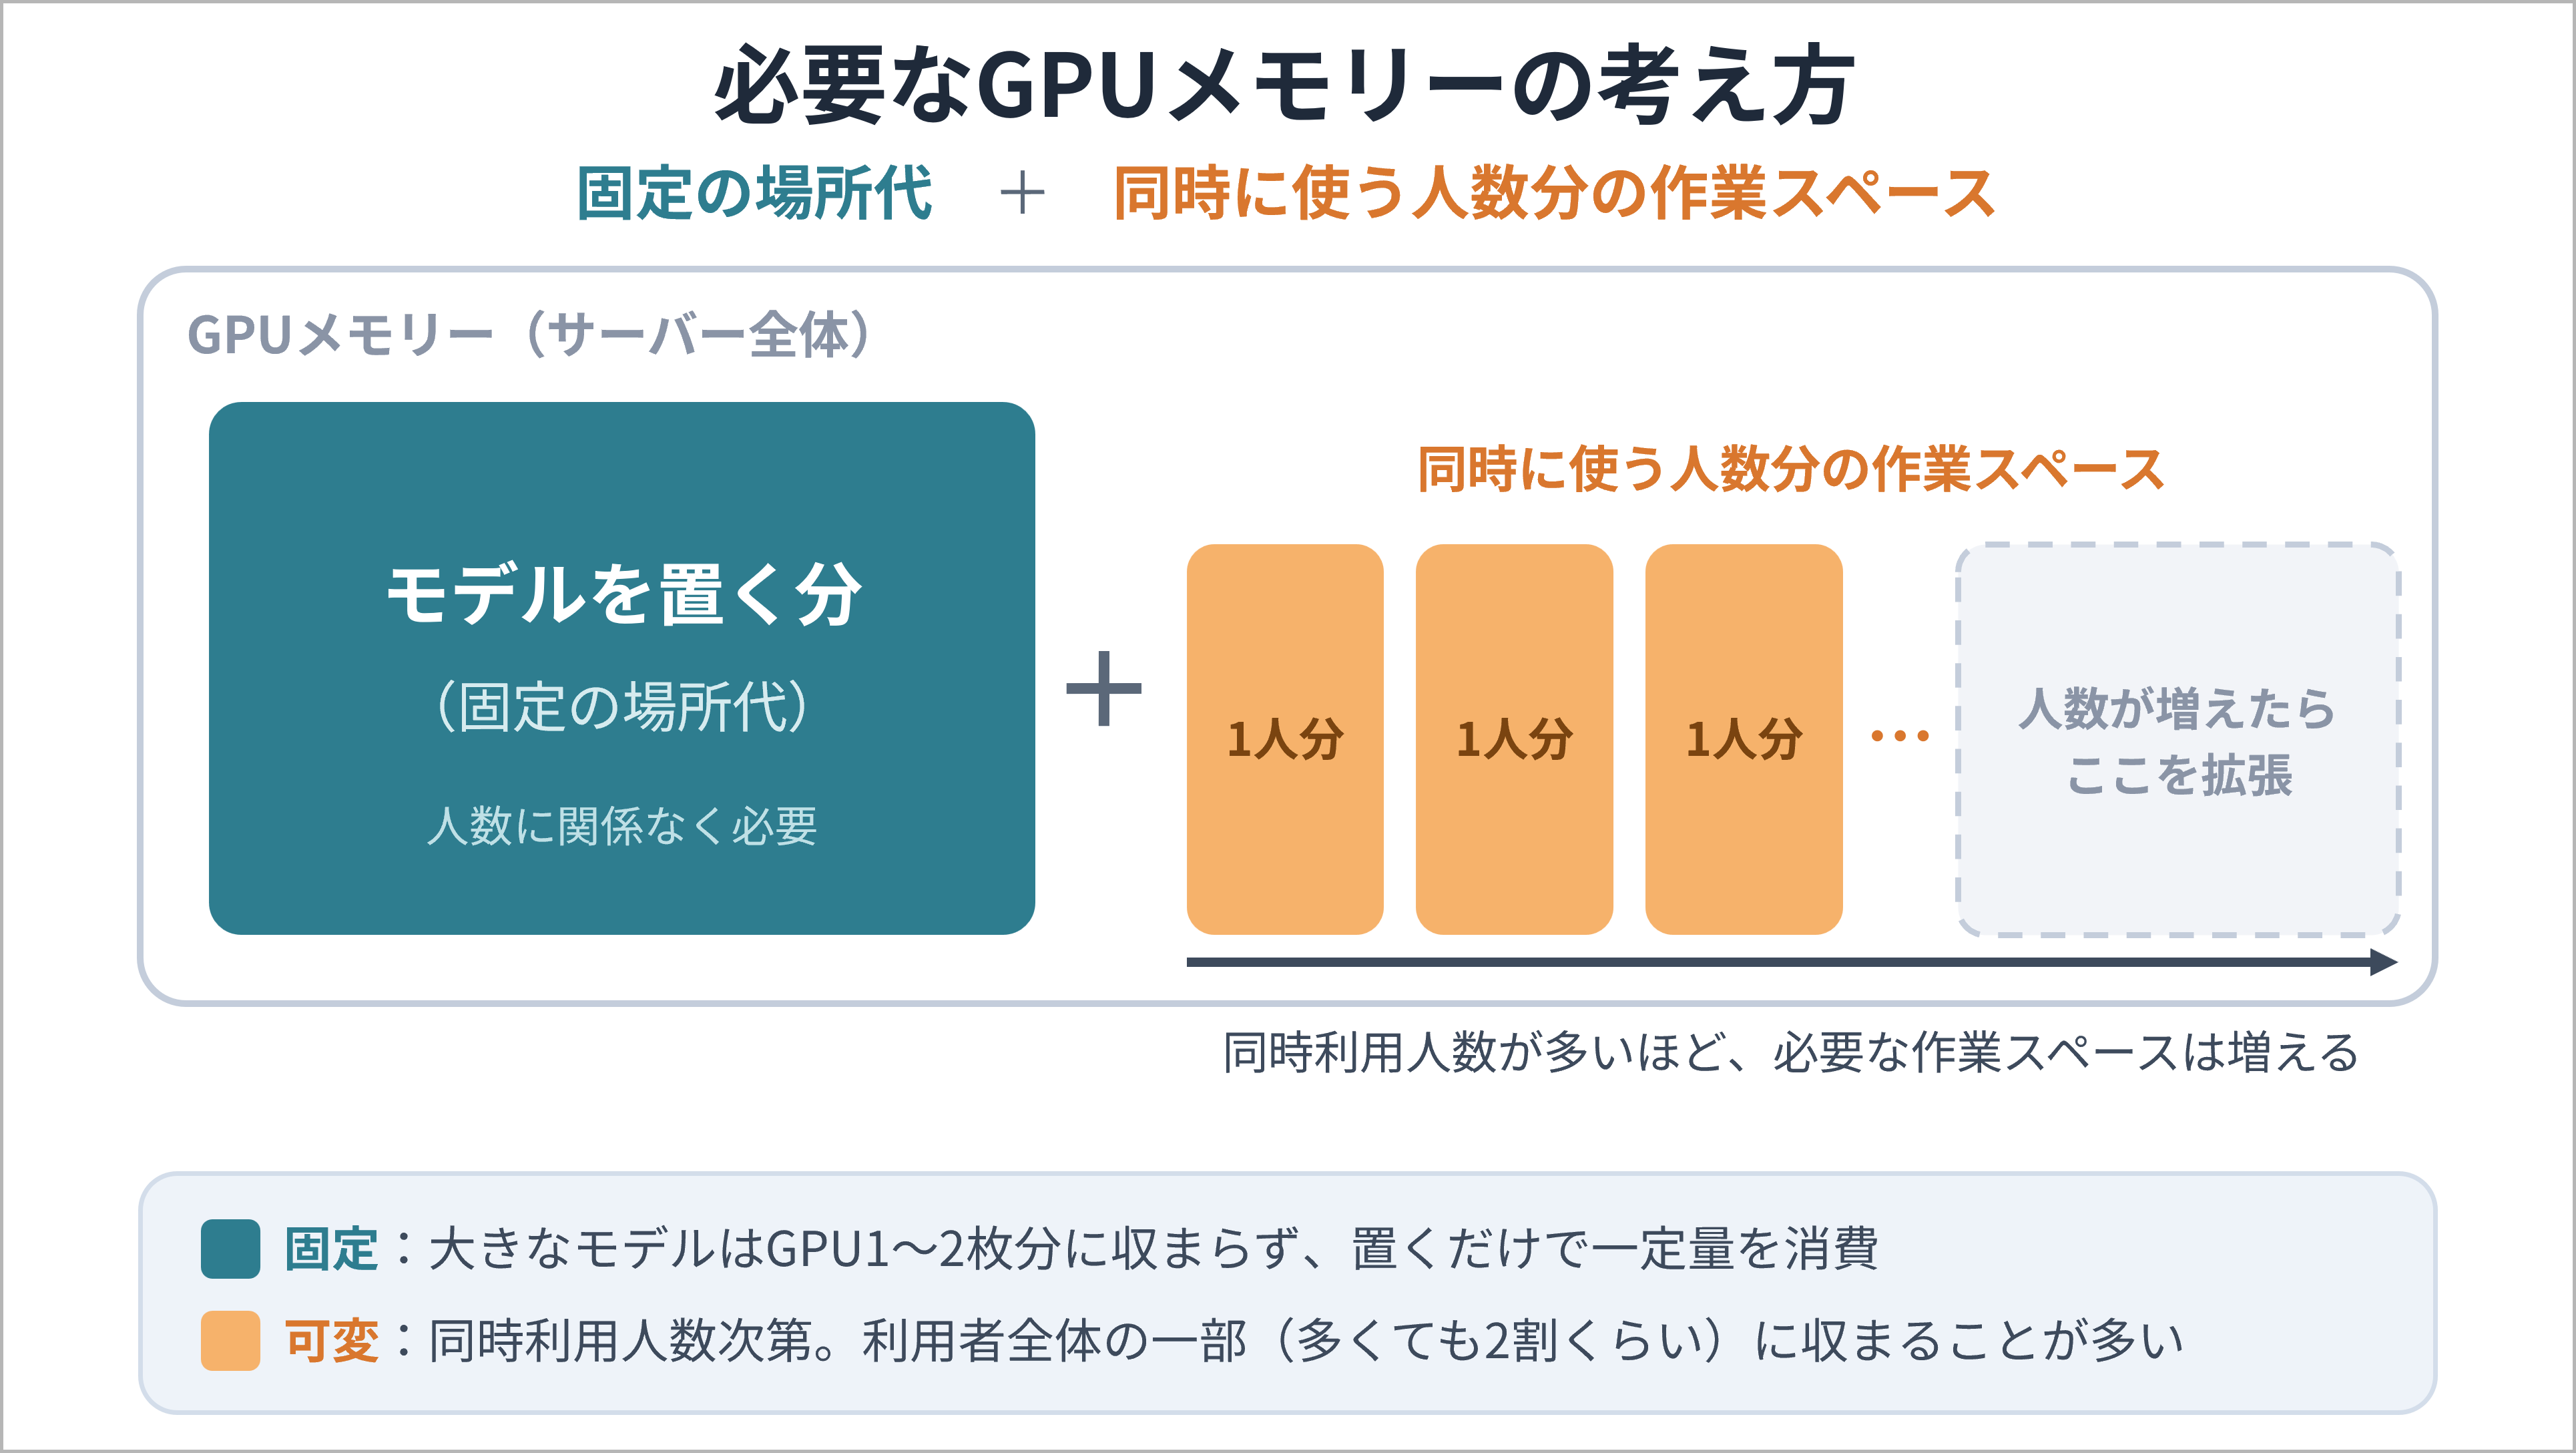
ケースの説明が終わったところで、本題のGPUの必要量について考察していきます。必要なGPUの量は、ざっくり「モデルを置いておくためのGPUメモリー」+「利用者が同時に作業するためのGPUメモリー」の合計で決まります。
・モデルを置いておくためのGPUメモリー:人数に関係なく必要な、いわば固定の場所代です。Kimi K2.7のような大きなモデルはGPU1〜2枚分には基本的に収まりません。
・利用者が同時に作業するためのGPUメモリー:同時に使う人が増えるほど、その人数分の作業スペースが追加で必要になります。(いわゆるKVキャッシュ)
ここで大事なのが、「同時利用人数」は「利用者数」とは違うという点です。
100人のチームでも、全員が同じ一瞬にボタンを押すわけではありません。実際に同時にAIへ問い合わせている人数は、全利用者の一部に留まるケースがほとんどです。
この前提で、同時利用人数ごとの目安を見ていきます。
🔷同時利用人数1〜5人
まず「試しに動かしてみたい」「一部のメンバーで使いたい」という段階です。
この規模であれば、NVIDIA DGX™ B200を8枚積んだサーバー1台が目安になります。
Kimi K2.7 くらいの大きなモデルでも、B200を8枚搭載した構成であれば十分に載せられ、1〜5人分の利用ならこの1台でしっかりまかなえます。むしろ5人分であればオーバースペックにも見えるかもしれません。しかし、「大きいモデルを自前で動かすなら、最小構成でもこのくらい」というスタートラインだと考えてください。まずはこの構成で始めて、利用者が増えてきたら次の段階に進む、という進め方が現実的です。
🔷同時利用人数5〜20人
チームや部署の日常業務で、みんながそこそこ使う段階です。
この規模になると、より余裕のある構成が欲しくなります。目安は、B200より1枚あたりのメモリーが大きいNVIDIA DGX™ B300を8枚積んだサーバー1台です。
同じ8枚でもメモリーに余裕が出るので、同時に使う人が増えても、それぞれの作業スペースをしっかり確保できます。「モデルを置く分」に加えて「同時利用人数分」の余裕をしっかり持たせる、というのがこの段階のポイントです。
🔷同時利用人数20〜100人
全社的に展開したり、本番サービスとして安定運用する段階です。
ここまで来ると、1台のサーバーでは足りず、NVIDIA DGX™ B300を積んだサーバーを複数台、あるいはそれらを高速につないだ大規模な構成(NVIDIA GB300 NVL72 のようなクラスタ)が必要になってきます。
この規模になると「あと何人が同時利用するのか」で必要なGPU数が変わってくるので、実際の利用状況を見ながらサーバーを増やしていく運用が一般的です。
ここは机上の計算だけで決めきらず、想定する使い方で一度動かしてみるのがおすすめです。
まとめ
改めて整理すると、必要なGPU数は「モデルを置いておくためのGPUメモリー(固定)」+「利用者が同時に作業するためのGPUメモリー」の合計で決まり、大きなモデルを自前で動かすなら最初からある程度の規模が必要になります。
|
同時利用人数 |
利用イメージ |
GPU構成の目安 |
| 1~5人 | お試し利用、一部メンバーで利用 | B200 × 4~8(DGX B200など)を1台 |
| 5~20人 | チーム・部署の日常業務利用 | B300 × 8(DGX B300など)を1台 |
| 20~100人 | 全社展開・本番サービス | B300 × 8を複数台 ~ GB300 NVL72クラスタ |
最初から完璧な規模を狙う必要はありません。まずは小さく始めて、利用者が増えたらサーバーを増やしていく、という考え方で最初に投資を進めるのが現実的だと思います。
※補足:
本記事の構成はあくまで目安です。実際には、利用者が増えて「同時に作業するためのGPUメモリー」が不足した場合でも、KVキャッシュを一時的にCPUメモリーへ退避させるなどの技術によって、LLMを動かし続けることができます(ただし、その分レスポンスは遅くなります)。
また、実際の運用では、モデルの種類やコンテキストサイズなど、考慮すべき点はほかにもたくさんあります。
必要なGPUは今後のアップデートによっても変わっていくため、机上の計算だけで判断せず、実際に運用しながら見極めていくことをおすすめします。
お問い合わせはこちら
マクニカはローカルLLMやエージェントの導入サポートをしております。ご興味のある方はぜひお問い合わせください。
関連製品ページ