- 半導体事業HOME
- マクニカの製品・サービス
-
技術情報

-
イベント・セミナー
- 取扱メーカー
- サポート
- お問い合わせ
- 製品購入はこちら
- 半導体事業のメルマガ登録


 条件を指定して絞り込む
現在2259件がヒットしています。check
第3話の内容
第1話・第2話では、ルーティングの実績(411件中402件がオンプレミスで完結)、性能の実測(AgentX MVPで同時50人が合格)、コストの試算(損益分岐 約45〜60名)を紹介しました。これらの数字をどのような環境で計測・集計したのか、自分の環境でも同じように試せるのか、気になった方もいるのではないでしょうか。
前提を1つだけ確認します。私たちのチームでは、オープンウェイトLLMのGLM-5.3-Flash(NVIDIAによる量子化版:nvidia/GLM-5.3-Flash-NVFP4)を、1台のGPUサーバー(NVIDIA DGX™ B200)上のvLLMで稼働させ、社内約30名によるAIエージェントの利用をオンプレミスで賄っています。さらに、NVIDIA NeMo™ Switchyardを使い、オンプレミスでは対応が難しいタスクだけをClaude(Opus 5.5)へエスカレーションする経路を設けています。第1話の「411件中402件」はこのルーティングの実績であり、第2話の「同時50人合格」はこのサーバーの性能実測です。
本記事では、その環境の中身を、次の順に紹介します。
1. モデルルーティング(NVIDIA NeMo Switchyard)の仕組みと設定
2. 再現可能なベンチマーク(AIPerf)の実行方法
3. サービング構成の選定(FP8 / NVFP4の比較)
4. コスト試算の計算過程
5. 同じ環境を構築する手順
AIPerf 0.13.0と、2026年9月時点のNeMo Switchyard v0.2.0の仕様に基づいています。どちらも開発が活発な OSSで、コマンド名・オプション名・設定スキーマは今後のバージョンで変わる可能性があります。実際に試す際は、公式ドキュメントで最新の情報を確認してください。
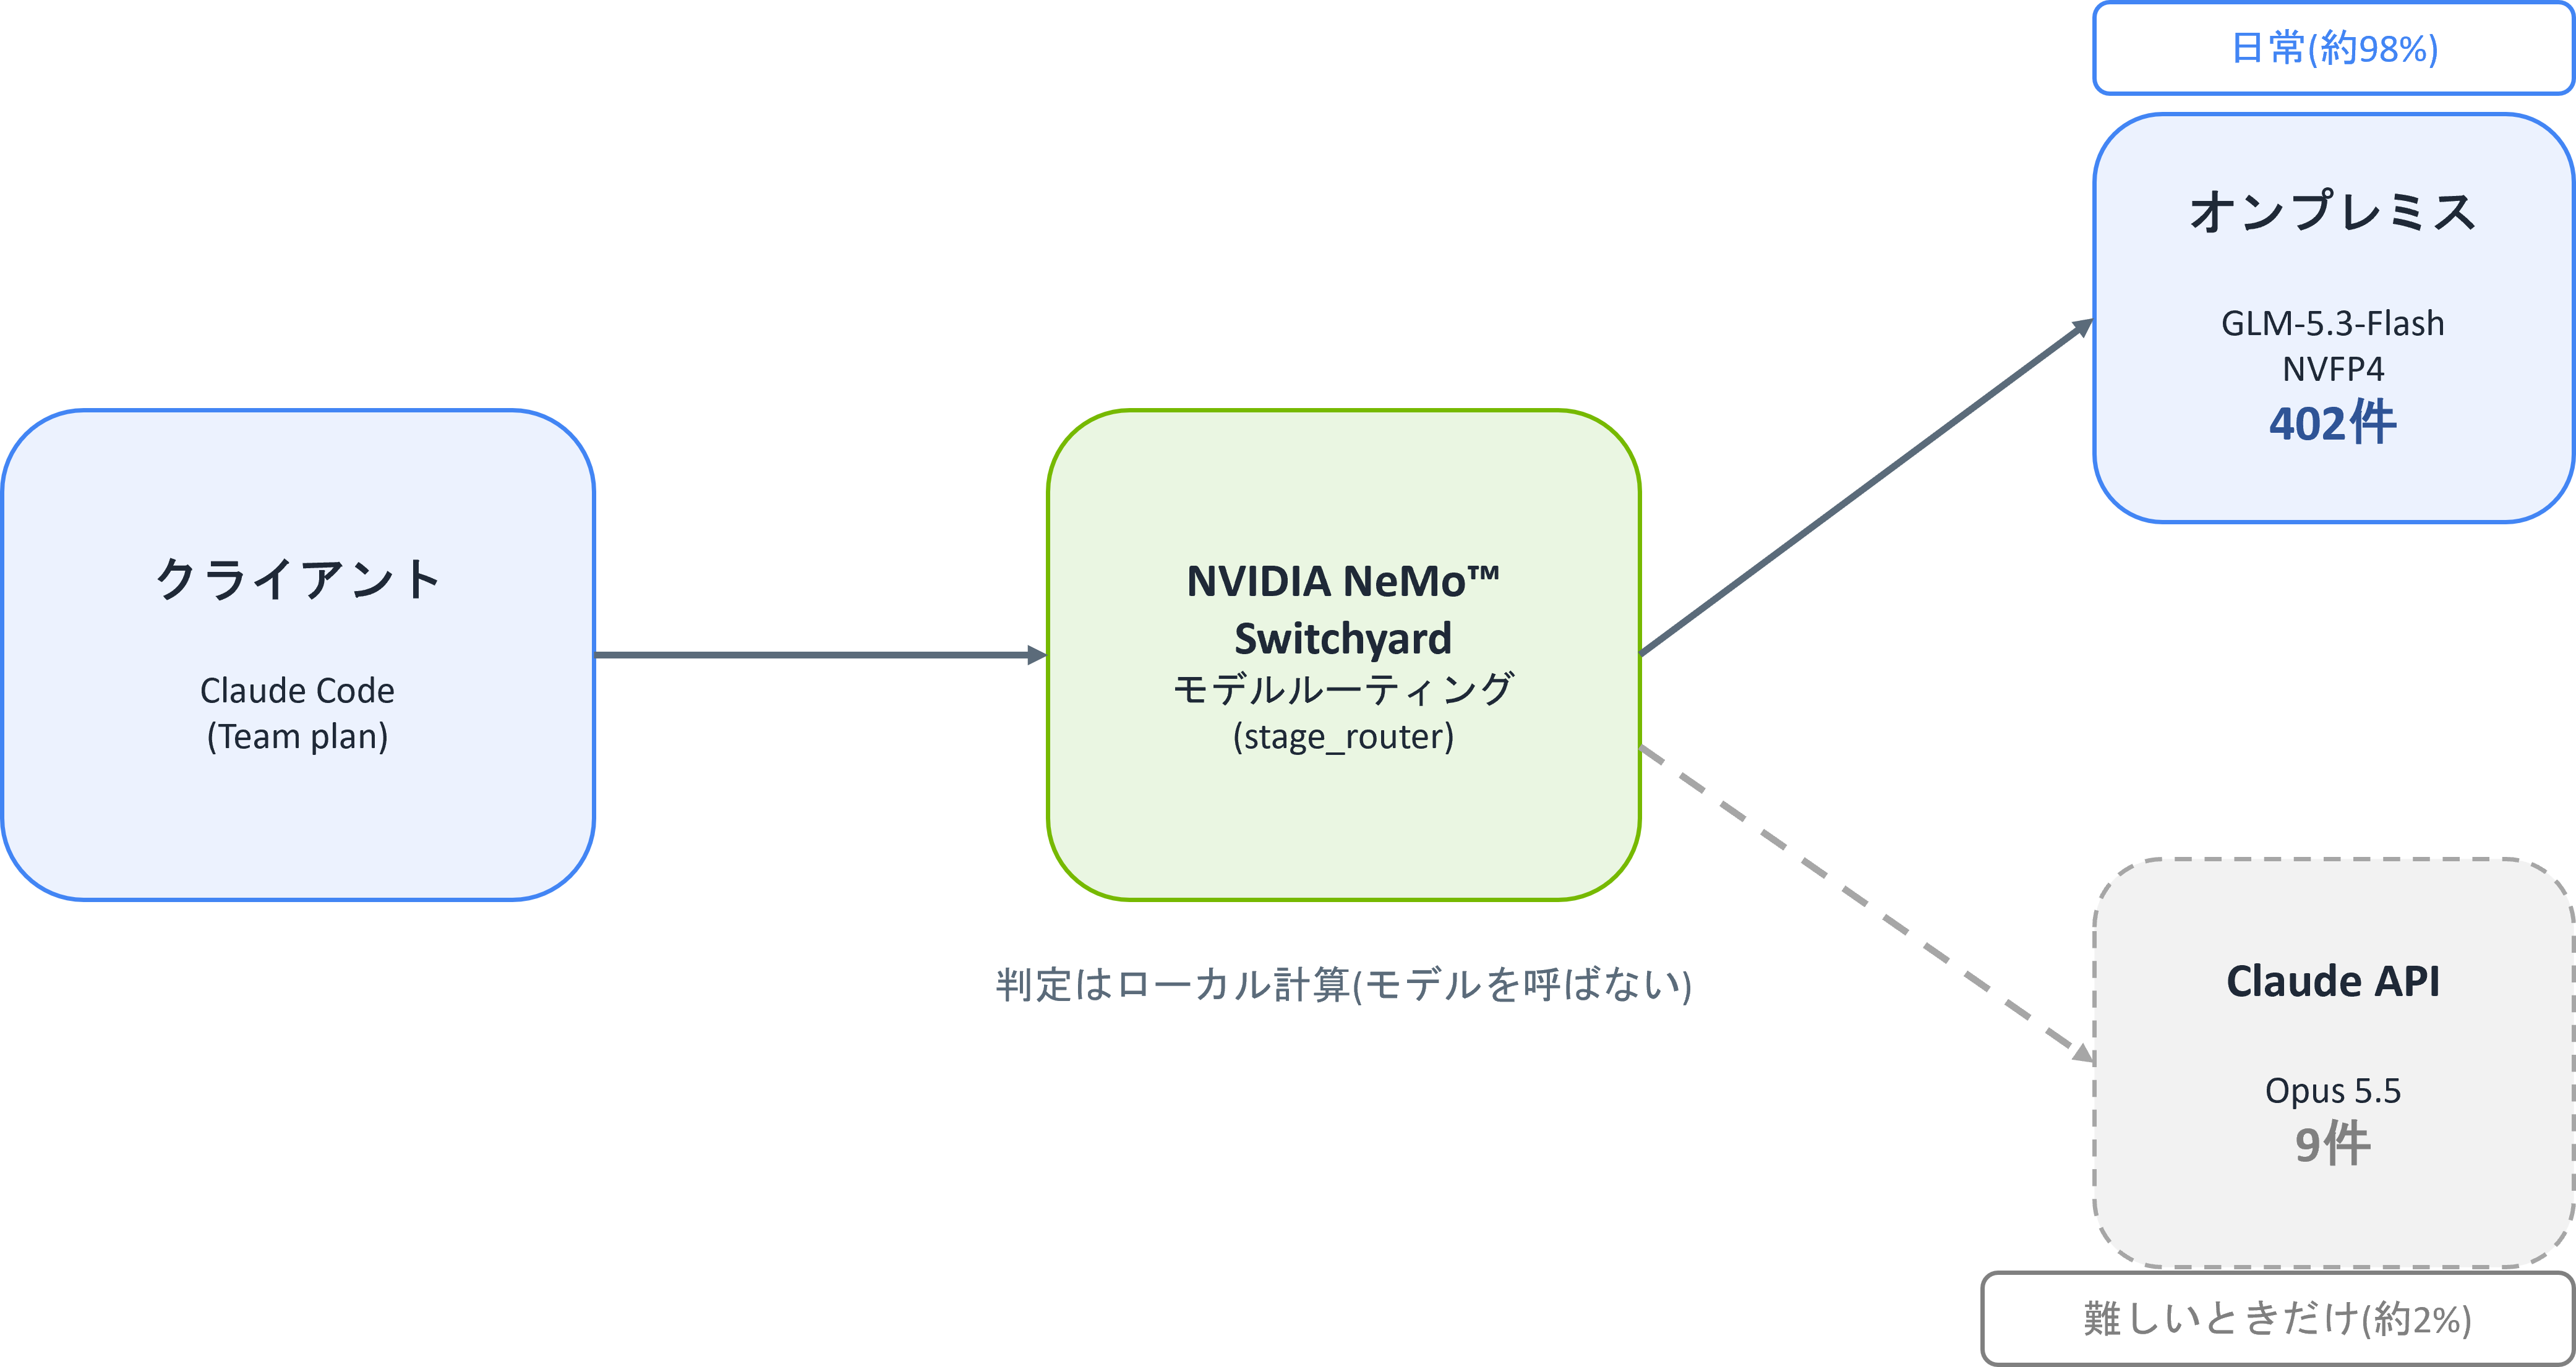
全体のアーキテクチャーは上図のとおりです。
クライアント(Claude Code)からSwitchyardを経由して、オンプレミスとClaude APIに振り分けています。日常業務のリクエストはオンプレミス側で処理し、対応しきれない難しいタスクだけをClaude APIへ送ります。第1話で紹介したGrafanaのダッシュボードは、この経路のメトリクスを可視化したものです。
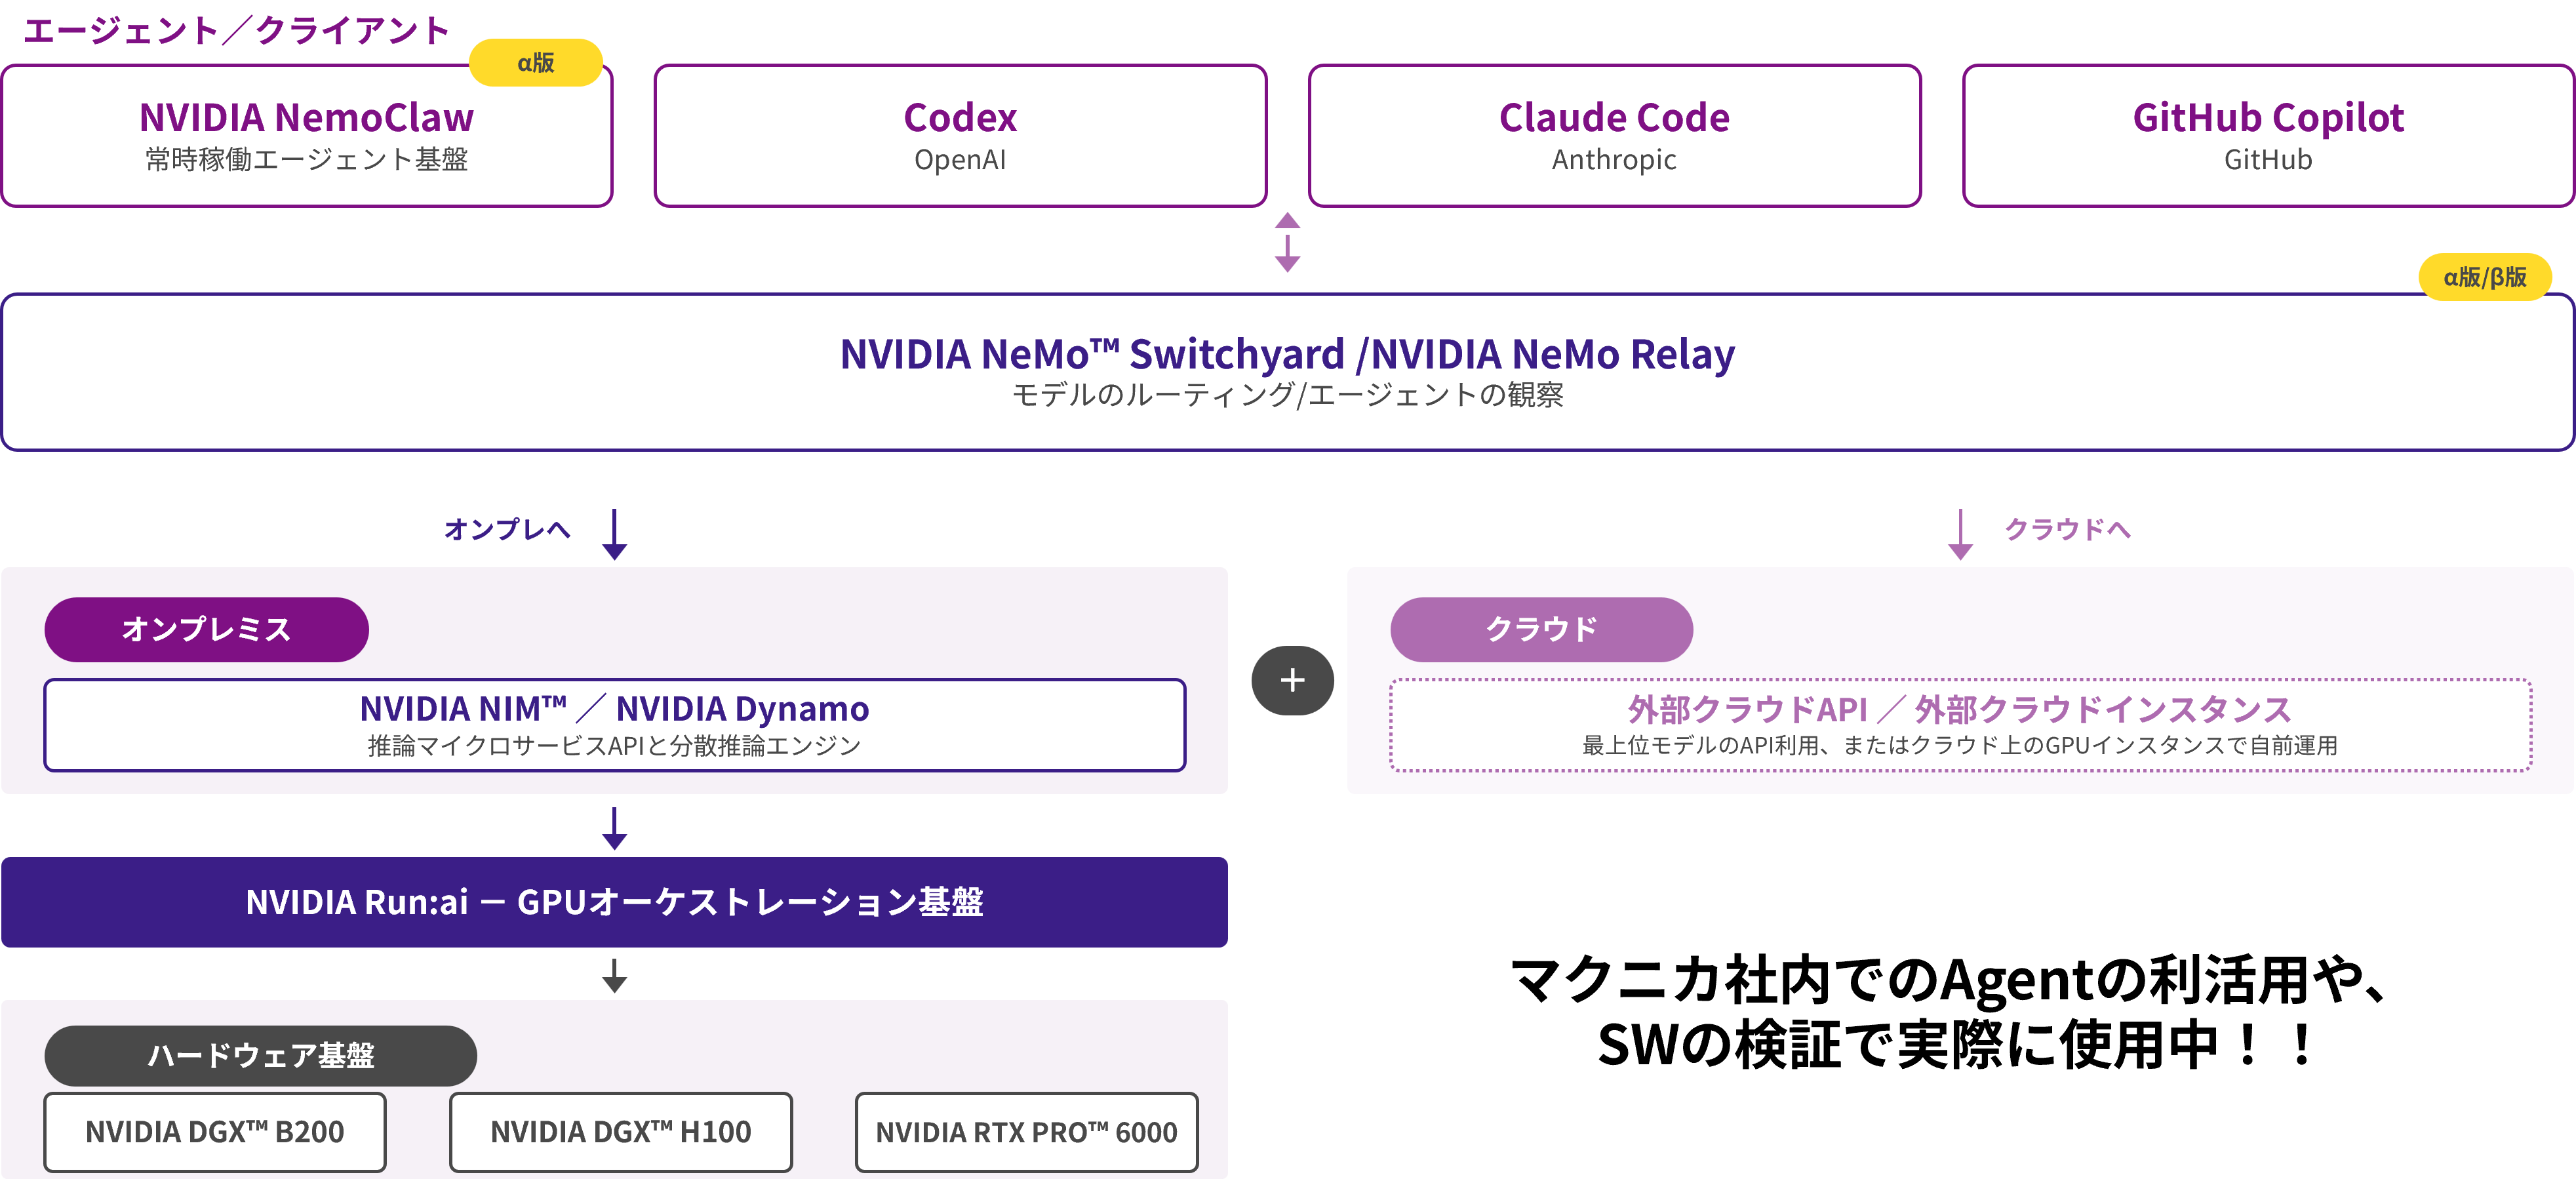
部門の検証環境全体は、第1話で紹介した上図のとおりです。
Claude Code / GitHub Copilot / Codexに加えて、常時稼働のエージェント基盤(NVIDIA NemoClaw )も同じ経路を使います。オンプレミス側はNVIDIA NIM™ / NVIDIA Dynamo の推論マイクロサービスを、NVIDIA Run:ai のGPUオーケストレーションで動かしています。ハードウェアはNVIDIA DGX™ B200です。
NVIDIA NeMo Switchyard:モデルルーティングの中核
役割と動作
Switchyard [1][2] は、OpenAI/Anthropic互換のAPIを単一のエンドポイントで受け、リクエストや作業の進み具合に応じてモデルを振り分けるオーケストレーション基盤です。公式のGitHubリポジトリでは、次のように説明されています。
Switchyard is an open-source library that helps an AI agent choose which model handles each request. It combines efficient models with more capable models so you can balance task success, cost, and latency on your workload.
(訳:Switchyardは、AIエージェントが各リクエストをどのモデルに処理させるかを選ぶのを助けるオープンソースライブラリです。効率的なモデルとより高性能なモデルを組み合わせることで、タスクの成功率・コスト・レイテンシーのバランスをワークロードの上で取れるようにします。)
動作は公式READMEの “How it works” に沿って整理すると3段階です。
(1) 使えるモデルを設定し、ルーティング方式を選ぶ。
(2) 方式がリクエスト、またはエージェントの直近のツール活動を調べる(方式によっては判定にモデルを呼ぶものもある)。
(3) ゲートウェイまたはアプリケーションが選ばれたモデルにリクエストを送る。
エージェントの作業の進行に合わせて、ルーティングは変わり得ます。
動作の流れは、公式READMEの「How it works」に沿って、大きく3段階に整理できます。
1. まず、利用するモデルを設定し、ルーティング方式を選択します。
2. 方式がリクエスト、またはエージェントの直近のツール活動を調べる(方式によっては判定にモデルを呼ぶものもある)。
3. 最後に、ゲートウェイまたはアプリケーションが、選択されたモデルへリクエストを送信します。
エージェントの作業の進行に合わせて、ルーティングは変わり得ます。
ルーティング方式の選択
ルーティング方式は複数あります。公式READMEでは、入口として Auto / Task / Execution(Stage) / Composite の4つが示され、routing overview ドキュメントが Plan/Execute、escalation、advisor、 sub-agent、random を含む全カタログを保持しています [2]。今回採用したのは stage_router(公式 READMEで Execution (Stage) と説明される方式)です。ツールの実行結果の履歴から作業の状態を推定し、ターンごとにモデルを選びます。
この方式を選んだのは、オンプレミス側のモデルの性能も向上しているためです。第1話で紹介したとおり、オープンウェイトのモデルは前世代のフロンティアモデルと同等の水準に達しており、日常業務の大半はオンプレミスで賄えます。そこで、まずオンプレミスで処理を進め、作業の進み具合から詰まりを検知したときだけクラウドへ昇格する方式が、この環境の実力に合うと判断しました。判定にモデルは使いません。スコアの計算は数ミリ秒以下のローカル処理なので、判定のためのコストはかからず、判定用モデルの障害で止まることもありません。
判定材料になるシグナルは次の4つです。
|
シグナル |
方向 |
意味 |
|
severity |
Opus寄り |
エラーの重大度(重大なエラーは単独でも昇格) |
|
spinning |
Opus寄り |
読み書きせず、同じ失敗を繰り返している |
|
exploring |
Opus寄り |
読む・計画するばかりで成果が出ていない |
|
production_intensity |
GLM寄り |
書き込み・編集の割合が高い(順調に進んでいる) |
判定は次の順に行われます。
1. 繰り返しの失敗重大なエラー・コンテキスト圧縮があれば、強制的にOpus(override)
2. 直近でOpusに上がっていれば、最大2ターンはOpusを維持(capable_hold。テストがきれいに通れば早めに解除)
3. シグナルのスコアがしきい値5を超えたらOpus(dimensions)
4. それ以外(曖昧なとき、ツール履歴がないとき)は既定のtierに倒す(fall_open)。
picker ="efficient_first" なので、既定はオンプレミス
第1話の個人検証(411件)では、判定129回のうち fall_open が120回、capable_hold が6回、 dimensions が3回でした。
スコアで上がった3回と、その直後の引き継ぎ6件が、Opus 5.5に送られた9件と一致します。
判定の内訳は、Switchyardの GET /v1/stats を見ると algorithm_stats.stage_router.routing_decisions として確認できます。
設定ファイル
実際に使っている設定ファイル( local-claude-glm.toml )の主要部分は次のとおりです。
schema_version = 1
[llm_clients.claude]
format = "anthropic_messages"
base_url = "https://api.anthropic.com"
forward_auth = true	# Claude CodeのOAuthトークンをAnthropic行きにだけ転送
[llm_clients.runai]
format = "openai_chat"
base_url = "http://<Run:ai上のvLLM>:30778/v1"
[targets.claude]
id = "claude-opus-5-5"	# Claude Opus 5.5
llm_client = "claude"
[targets.glm]
id = "local"	# GLM-5.3-Flash NVFP4版(Run:ai上のオンプレミス)
llm_client = "runai"
[routes.auto]
id = "switchyard/auto" type = "stage_router" capable_target = "claude" efficient_target = "glm"
picker = "efficient_first"	# 曖昧なときはオンプレミスに倒す
confidence_threshold = 0.5	# 下げるほどClaudeへ上がりやすい
[routes.auto-1m]
id = "switchyard/auto[1m]"	# 1Mコンテキスト用([1m]サフィックス付きの別ルート) type = "stage_router"	# autoと同じ内容 + context_window = 1000000 capable_target = "claude"
efficient_target = "glm" picker = "efficient_first" confidence_threshold = 0.5
context_window = 1000000
[routes.fast]
id = "switchyard/fast"	# タイトル生成などの裏方処理はGLMに直行
type = "passthrough" target = "glm"
# Claude Codeのデフォルトモデル名での救済ルート(ANTHROPIC_MODEL未設定の
# セッションやバックグラウンド処理が404にならないようにする)。
 [routes.alias-opus]
id = "claude-opus-5-5"	# デフォルトの上位名はOpus行き
type = "passthrough"
target = "claude"
[routes.alias-sonnet]
id = "claude-sonnet-5"
type = "passthrough"
target = "glm"
[llm_clients.claude] の forward_auth = true は、呼び出し元(Claude Code)が持つOAuthトークンを、Anthropic行きのリクエストにだけ転送します。GLM側には認証情報が渡りません。トークンの発行・更新はClaude Codeがすべて行うため、サーバー側の認証管理はゼロで済みます。
Anthropic Messages形式とOpenAI Chat形式の間は、中間表現(IR)を挟んで相互に変換されます。これにより、クライアントであるClaude CodeはAnthropic形式だけを、オンプレミスで稼働するvLLMはOpenAI形式だけを意識すればよく、両者の形式の違いはSwitchyardが吸収します。
設計上の要点
しきい値の意味から説明します。 confidence_threshold = 0.5 は、コーディング系ベンチマーク(SWE-bench Pro)で較正された推奨の出発点です。1つのシグナルが寄与できるのは最大でも約0.46なので、複数のシグナルが重なったときだけOpusに上がり、単発のエラーだけではエスカレーションしません。下げるとOpusに上がりやすくなります。
Claude Code側から見た裏方処理の分岐も押さえておくと構成の理解が速くなります。
・バックグラウンド呼び出し:
会話タイトルの生成など、ツールを持たない単発の小タスク。
ANTHROPIC_SMALL_FAST_MODEL の担当で、 switchyard/fast (GLM直行)が受けます
・サブエージェント:
ツールを持ち、複数ターン動く独立エージェント。メインモデルの担当で、 switchyard/auto のルーティング対象です(探索が詰まればOpusへの昇格判定も働きます)
起動方法
Switchyardサーバーは、cargoでインストールして、前述の設定ファイルを指定して起動します。
(Rustがなければ curl https://sh.rustup.rs | sh で導入できます)
cargo install --locked switchyard-server
switchyard-server --config local-claude-glm.toml --port 31001
これで、OpenAI/Anthropic互換のエンドポイントがポート31001で待ち受けます。クライアント側の接続先の変更は、記事の最後の「同じ環境を構築したい人へ」で紹介します。
ベンチマーク:実際のClaude Codeセッションを再生する
第2話の性能実測に使った、AIPerfの実行方法を説明します。AIPerfはNVIDIAの推論ベンチマークツールで、任意の推論サーバーで提供される生成AIモデルの性能を測定し、コマンドライン表示と詳細なレポートでメトリクスを出力します [3][4]。PyPIで公開されており、uvで仮想環境にインストールできます。
uv venv
source .venv/bin/activate
uv pip install aiperf
AgentX MVP(SemiAnalysis InferenceX)[5] は、実際のClaude Codeのセッション393本を、記録された順序と間隔のまま再生する公開ベンチマークです。出力の打ち切りやキャッシュの水増しを禁じた実行条件がツール側で固定され、計測する側が後から条件を変えることはできません。AIPerfのシナリオの1つとして提供されています。公式チュートリアル「InferenceX AgentX MVP」が --scenario inferencex-agentx-mvp の使い方を説明しています [4][6]。
aiperf profile --scenario inferencex-agentx-mvp # これだけでルールがロックされる実際の実行コマンドは次のとおりです。
aiperf profile \
--scenario inferencex-agentx-mvp \
-m local --tokenizer zai-org/GLM-5.3-Flash --url <推論エンドポイント> \
--endpoint-type chat \
--public-dataset semianalysis_cc_traces_weka_062126 \
--concurrency 50 \
--benchmark-duration 1800 \
--random-seed 42 \
--use-server-token-count \
--workers-max 256 \
--artifact-dir benchmark/results/agentx-mvp/c50 \
--goodput "output_token_throughput_per_user:50 time_to_first_token:2000" \
--streaming --extra-inputs ignore_eos:true \
--cache-bust first_turn_prefix \
--system-idle-gap-cap-seconds 10
主なオプションの意味は次のとおりです。
|
オプション |
意味 |
|
--scenario inferencex-agentx-mvp |
シナリオの指定。これ一つで実行条件(ignore_eos、 streaming、cache-bust、間隔の保持など)がロックされ、結果に submission_valid スタンプが付く |
|
--public-dataset |
コーパスの指定。日付固定の semianalysis_cc_traces_weka_062126 (Claude Codeのセッション393本)[7] |
|
--concurrency |
同時に進行する会話の数(後述) |
|
--benchmark-duration |
計測秒数。既定1,800秒 |
|
--random-seed |
乱数シード。固定すると、再構成済みデータセットのディスクキャッシュが効いて2回目以降の開始が速くなる |
|
--use-server-token-count |
トークン数をクライアント側の概算ではなく、サーバーの報告値で数える |
|
--goodput |
「快適」の判定条件。 output_token_throughput_per_user:50 (1人あたり50トークン/秒以上)と time_to_first_token:2000 (最初の1文字まで2秒以内) |
AgentX MVPがロックするのは実行条件(セッションの再生順序・間隔など)だけで、「何を快適とみなすか」は計測する側が定めます。第2話で述べた快適の基準は、「1人あたり50トークン/秒以上かつ最初の1文字まで2秒以内」を満たしたリクエストが全体の95%以上(SLO)というもので、このオプションで事前に固定したものです。判定はAIPerfが出力する good_request_fraction (SLOを満たしたリクエストの割合)が0.95以上かどうかで行います。結果は、1人あたりの生成速度(tok/s)を主な指標、TTFTを補助の指標として読みます。SLOは私が計測前に設定したもので、AgentX MVPの公式指標ではありません。
ロックされるルール
シナリオが強制する主な設定と、その理由は次のとおりです。
・ ignore_eos : 要求された長さまで必ず生成させる(出力を早く打ち切って負荷を下げるのを防ぐ)
・ streaming : ストリーミングでの計測を強制する
・ cache-bust first_turn_prefix: 再生のたびに先頭のプレフィックスを変え、使い回しによるキャッシュの水増しを防ぐ
・ system-idle-gap 10s / 記録された間隔の保持: 人が作業しているテンポを再現する
・ 日付固定のコーパス / seed必須: 誰がいつ測っても同じ条件にする
実行前チェックと失敗パターン
計測は、コーパスの再構成、trajectory warmup、30分間の計測、submission_valid の判定の順に進みます。初回はコーパスのダウンロードと再構成に数分かかるため、データセット構成のタイムアウト( AIPERF_DATASET_CONFIGURATION_TIMEOUT )を既定値より長く伸ばしておくと安全です。
結果はアーティファクトディレクトリー( --artifact-dir )に出力されます。合否は profile_export_aiperf.json の metadata.submission_valid と、失敗時は submission_invalid_reasons (例:手動キャンセルなら run_cancelled )で確認します。再現性は、seedの固定、同じディレクトリーに保存されるmanifest.json、日付固定のコーパスで担保しています。
同時セッション数の意味に注意する
--concurrency の指定にも注意が必要です。AIPerfの --concurrency は、同時に処理されているリクエストの数ではなく、同時に進行している会話の数(同時セッション数)を意味します。人はターンの合間に待つので、この2つは一致しません(AgentXの同時セッション数50本では、同時処理リクエスト数は平均約10件)。利用者数をそのまま--concurrency に入れると必要なリソースを見誤るため、第2話では1会話を1人(同時セッション数=同時利用者数)とみなしたうえで、ピーク同時利用率を使って利用者数に換算しました。
サービング構成の選定:FP8 / NVFP4 の比較
起動オプション
推論サーバー(vLLM)は、Run:ai上で次のオプションで起動しています。
vllm serve nvidia/GLM-5.3-Flash-NVFP4 \
--tensor-parallel-size 8 \
--kv-cache-dtype fp8 \
--tool-call-parser glm47 \
--reasoning-parser glm45 \
--enable-auto-tool-choice
エージェントのワークロードはツール呼び出しを伴うため、 --tool-call-parser / --enable-auto-tool-choice は必須です。KVキャッシュはFP8で圧縮し(重みのNVFP4とは別物です)、節約したメモリをキャッシュ容量に回しています。プレフィックスキャッシュは既定で有効です。
比較結果
GLM-5.3-FlashのFP8版とNVFP4版(nvidia/GLM-5.3-Flash-NVFP4)の2構成を、同じ条件・同じseed・同じコーパス(AgentX MVP)で比較しました。
NVFP4の詳細については、以下の記事をご参照ください。
計測点は同時10〜200人の6段階で、それぞれ30分ずつ計測しています。
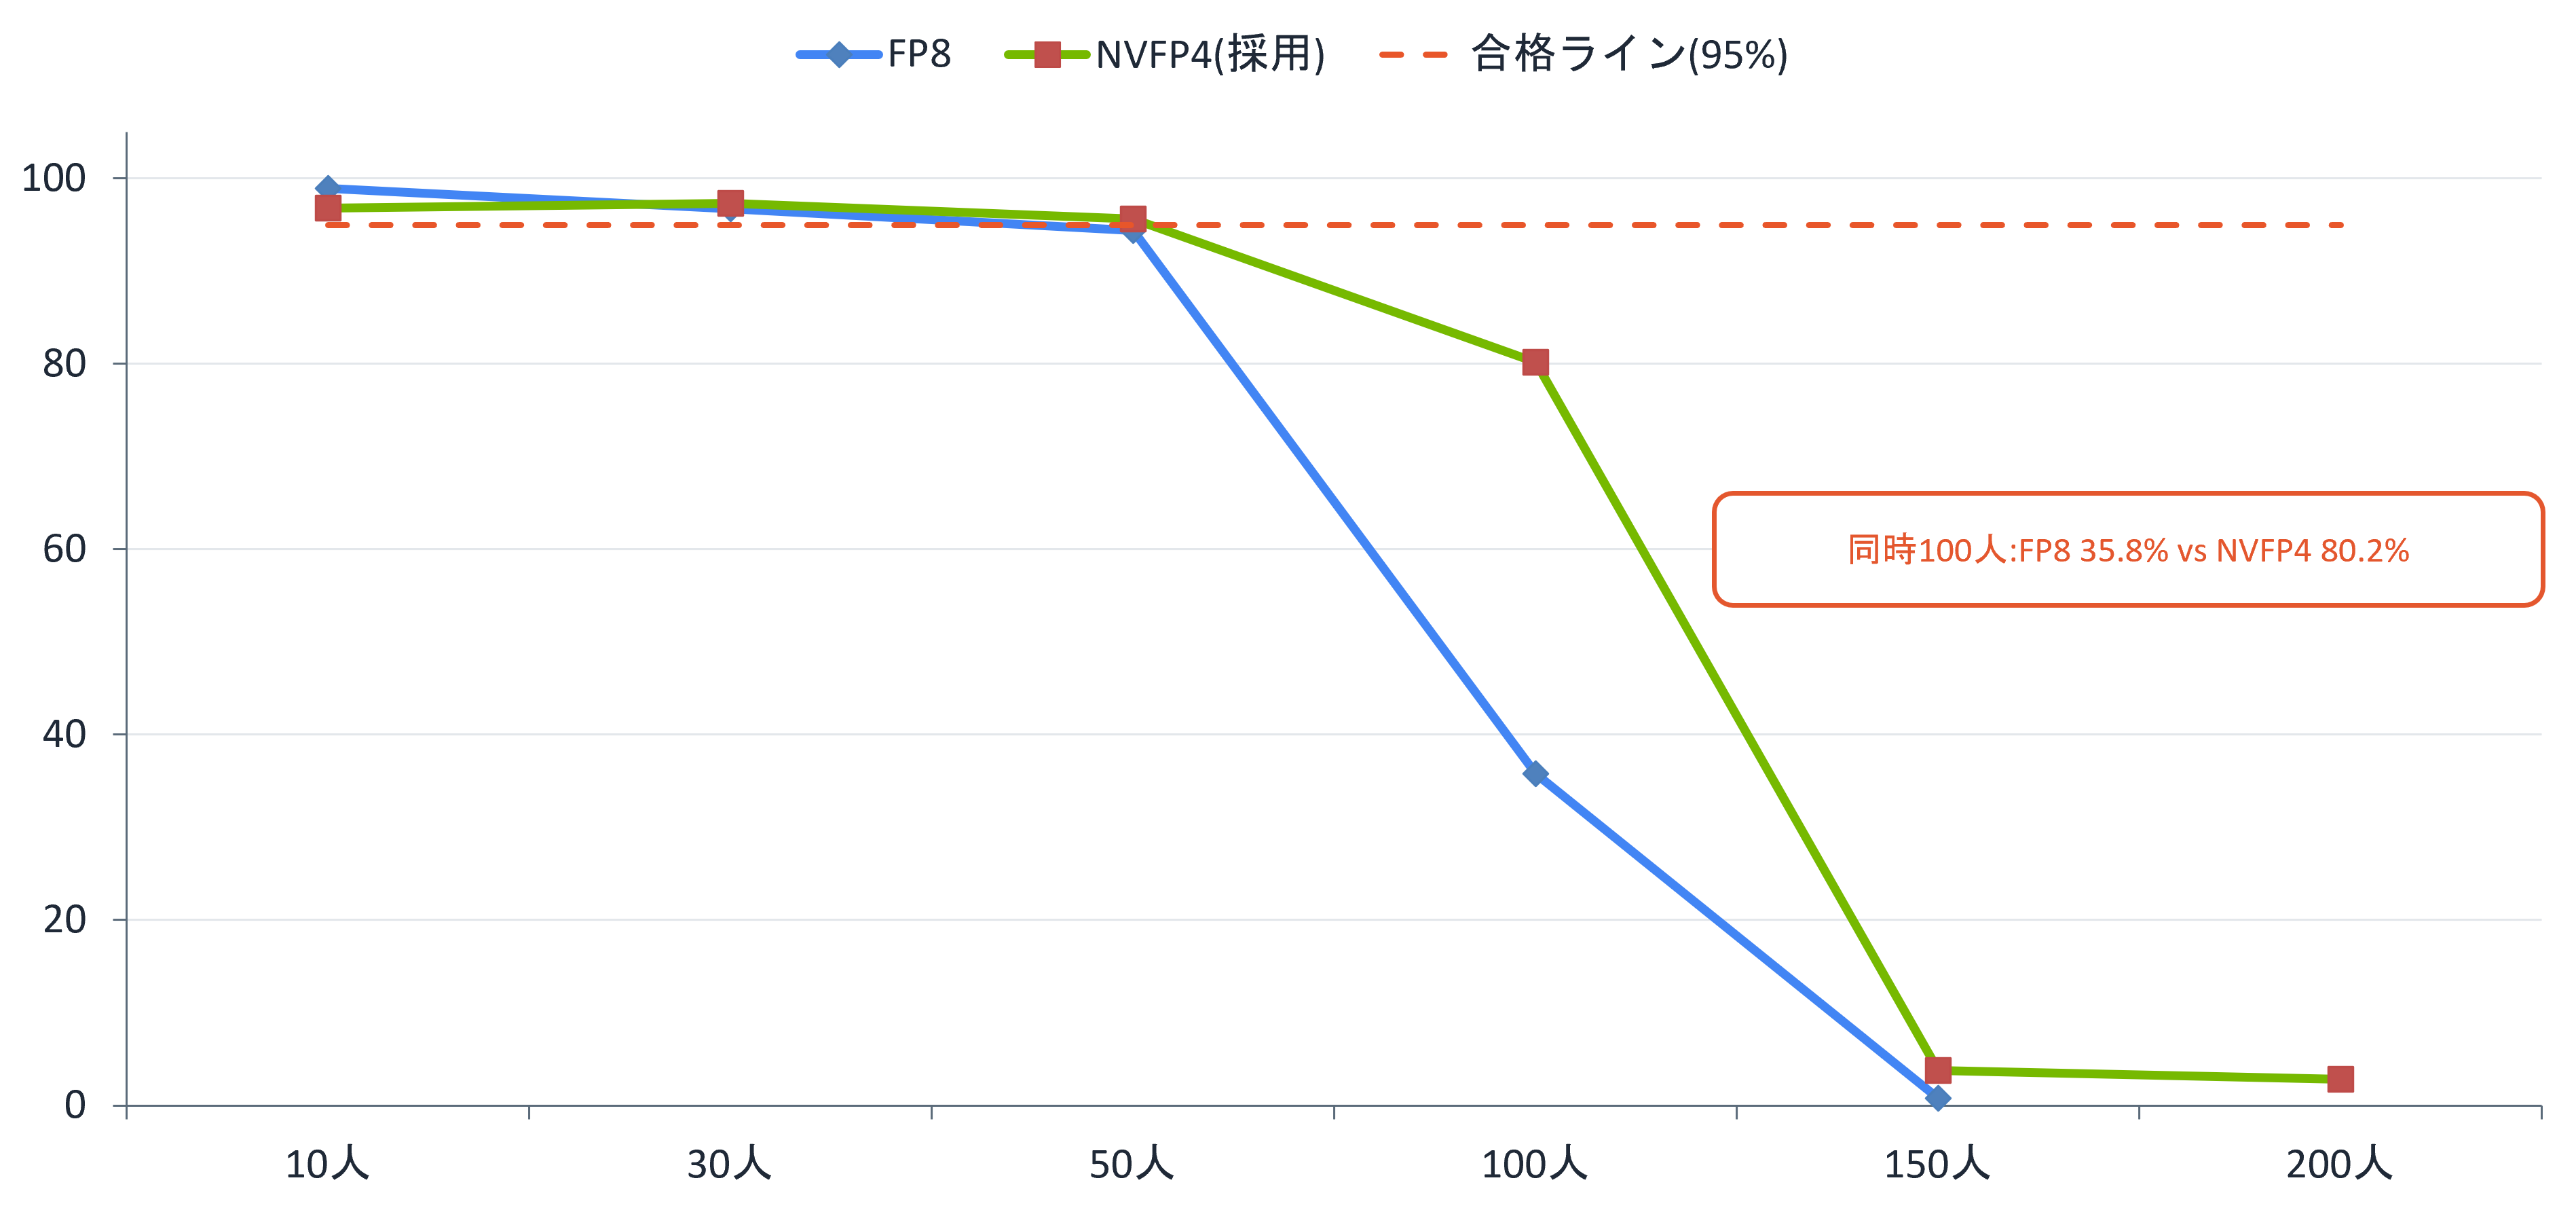
比較の結果、NVFP4版を採用しました。理由は次のとおりです。
・ 1人あたりの生成速度(中央値)は、すべての人数でNVFP4がFP8を上回り、混雑するほど差が開く(同時10人で+13%、50人で+23%、100人で+33%)
・ 同時100人の快適率は、FP8の8%に対してNVFP4は80.2%
なお、これは量子化形式の比較の一例です。サービング構成はワークロードに応じてさまざまに調整でき、たとえばKVキャッシュのデータ型や並列構成(TP/DP)、バッチの戦略などが挙げられます。投機的デコーディング(Speculative Decoding)のように、小さなドラフトモデルで候補トークンを生成し、大きなモデルで検証する手法を使えば、出力品質を保ったまま生成速度を高めることも可能です。最終的には、自社のワークロードで複数の構成を比較して選ぶことになります。
コスト試算の計算過程
第2話で示したコスト試算の計算過程を示します。まず前提を整理します。実運用データは、利用者約 30名・約4,300リクエスト/日(年間約102.7万件)・トークン量は年間 Input 約1,317億 / Output 約5.4億です。比較単価は、GLM-5.3-Flashが第三者機関の総合スコアで同点だった前の世代のフロンティアモデル、Claude Opus 4.8のAPI料金を使います。換算の前提は、1USD=160円、年間240営業日、初期投資(GPUサーバーなどの設備)1億円を5年定額償却(2,000万円/年)+ランニングコスト(弊社の概算)1,800万円で、オンプレミス側の年間コストは約3,800万円(償却込み、以下TCO)です。為替と単価は変動するため、金額そのものよりも前提と計算式を確認し、自社の数字に置き換えて使ってください。
API単価の一次情報源
2026年9月15日に公式の料金ページで確認した単価です [8]。
|
項目 |
単価 |
|
Claude Opus 4.8 Input / Output |
$5 / $25 per MTok |
|
キャッシュ read(ヒット) |
$0.50 per MTok |
|
5分キャッシュ write |
$6.25 per MTok |
|
1時間キャッシュ write |
$10 per MTok |
上記の単価を元にコストの試算を行いました。
実運用試算の式(第2話の試算)
年間Input 131,700MTok / Output 540MTok に対して:
素(キャッシュ不使用): コスト[$] = Input × 5 + Output × 25
キャッシュあり(5分): コスト[$] = Input × (ヒット率×0.5 + (1−ヒット率)×6.25) + Output × 25 (1USD=160円)
・ 素:約1億750万円 → 90%: 約2,480万円(▲77%)/ 95%(第2話の実測に近い値): 約1,880万円
・ キャッシュありの式は、ミスした分をすべてキャッシュwrite($6.25)で払う想定です。ヒット率0%を代入すると全Inputをwrite単価で払うことになり、素の単価より高い約1億3,390万円になる点に注意してください。
ベンチマークと同じ負荷を長時間に延長した計算過程(第2話の参考)
元データはAgentXの同時50人•NVFP4版•計測1,792秒で、入力は合計1億9,803万トークン、出力は合計167.9万トークンでした。ここから次のように計算しています。
・ 1人あたりのレート:入力 2,210 tok/s・出力 7 tok/s(1本の会話が30分で約37リクエストを処理)
・ ×8時間(28,800秒)×240日:1人あたり年間 Input 約153億 / Output 約3億トークン、約14.2万リクエスト
・ キャッシュ90%で1人あたり約315万円/年 → 利用者50名で約1億5,800万円 → オンプレミスTCO 3,800万円との差額 約1億2,000万円/年 → 初期投資1億円は1年弱で回収
さらに「1日24時間・年間365日」(4.56倍)に広げると、1人あたり年間 Input 約697億 / Output 約5.9億トークンとなり、キャッシュ90%で1人あたり約1,440万円/年、利用者50名で約7.2億円です。このペースは、実運用のペース(1人あたりInput 約44億トークン/年)の約3.5倍にあたるため、第2話ではエージェントの利用が広がった場合の目安として扱っています。
試算結果(第2話から再掲)
第2話で示した試算結果の表を、計算との対応のために再掲します。
|
キャッシュヒット率 |
年間API相当額 |
キャッシュなしとの比較 |
|
なし(参考) |
約1億750万円/年 |
− |
|
90%(基準) |
約2,480万円/年 |
▲77% |
|
95%(性能測定の実測に近い値) |
約1,880万円/年 |
▲82% |
キャッシュヒット率90%(基準)の場合
|
利用者数 |
同時利用者数 (ピーク同時利用率30〜50%想定) |
API相当額/年 |
オンプレミス TCO/年(償却込み) |
年間差額 |
初期1億円の回収期間※ |
|
30名(現在) |
10〜15人 |
約2,480万円 |
約3,800万円 |
▲1,320万円 |
約15年(耐用5年内に回収不能) |
|
50名 |
15〜25人 |
約4,140万円 |
約3,800万円 |
+340万円 |
約4年3ヶ月 |
|
60名 |
18〜30人 |
約4,960万円 |
約3,800万円 |
+1,160万円 |
約3年2ヶ月 |
|
100名 |
30〜50人 |
約8,270万円 |
約3,800万円 |
+4,470万円 |
約1年6ヶ月 |
|
150名 |
45〜75人 |
約1億2,410万円 |
約3,800万円 |
+8,610万円 |
約11ヶ月 |
キャッシュヒット率95%の場合
|
利用者数 |
同時利用者数 (ピーク同時利用率30〜50%想定) |
API相当額/年 |
オンプレミス TCO/年(償却込み) |
年間差額 |
初期1億円の回収期間※ |
|
30名(現在) |
10〜15人 |
約1,880万円 |
約3,800万円 |
▲1,920万円 |
回収不能 |
|
50名 |
15〜25人 |
約3,130万円 |
約3,800万円 |
▲670万円 |
約7年7ヶ月(耐用5年内に回収不能) |
|
60名 |
18〜30人 |
約3,750万円 |
約3,800万円 |
▲50万円 |
約5年2ヶ月(耐用5年内に回収不能) |
|
100名 |
30〜50人 |
約6,250万円 |
約3,800万円 |
+2,450万円 |
約2年3ヶ月 |
|
150名 |
45〜75人 |
約9,380万円 |
約3,800万円 |
+5,580万円 |
約1年4ヶ月 |
※表中の「初期1億円の回収期間」と「年間差額」は、計算方法が異なります。金額は10万円単位で丸めています。
キャッシュヒット率の感度分析
オンプレミスTCO 3,800万円/年(償却込み)と、利用者30名の実績から比例配分した1人あたりのAPI相当額を比べた、損益分岐の利用者数です。
|
キャッシュヒット率 |
1人あたりAPI相当額/年 |
損益分岐 |
|
素(キャッシュ不使用) |
約360万円 |
約11名 |
|
80% |
約120万円 |
約31名 |
|
85% |
約100万円 |
約37名 |
|
90%(基準) |
約80万円 |
約46名 |
|
95%(第2話の実測に近い値) |
約60万円 |
約61名 |
ヒット率が高いほど外部APIは安くなり、損益分岐の利用者数は上がります。第2話の基準の90%は、同話の性能測定での実測(93〜96%)よりオンプレミスに有利な側の仮定です。
ピーク同時利用率の換算(第2話)
ピーク同時利用率は、利用者のうち、ピーク時に同時にLLMへ作業を依頼している人の割合(ピーク時の同時利用者数 ÷ 利用者数)です。高めに見積もって50%と仮定し、次のように換算しました。
・ 同時50人合格 ÷ 50%(ピーク同時利用率) = 利用者約100名
・ 同時50人合格 ÷ 30%(ピーク同時利用率) = 利用者約170名
この換算を利用者数ごとに見ると、利用者100名ならピーク時の同時利用者数は50人、170名なら約50人、150名なら45〜75人です。150名は、ピーク同時利用率が30%なら基準を満たす範囲に収まります。最近は1人が同時に複数のセッションを並列で走らせることもよくあります。そのためヘビーユーザーが使用する場合は1人あたりの利用量が前提よりも多くなり、回収可能な人数は、ここで示した数値よりも少なくなります。
同じ環境を構築したい人へ
構築の手順は、Switchyardサーバーの起動と、Claude Codeの接続先の変更の2ステップです。サーバーの起動は、前述の「起動方法」のとおりです。
次に、Claude Codeの接続先をSwitchyardに向けます。3つの環境変数を設定して起動するだけです。
export ANTHROPIC_BASE_URL=http://<Switchyardサーバー>:31001
export ANTHROPIC_MODEL="switchyard/auto[1m]"	# ルートIDを指定(1Mコンテキスト)
export ANTHROPIC_SMALL_FAST_MODEL="switchyard/fast" # 裏方処理をGLMに直行
claude
ANTHROPIC_MODEL にルートIDを設定するのが、ルート名の完全一致の問題を避ける最も簡単な方法です。未設定のままでも404にならないように、前述の設定ファイルのように、デフォルトのモデル名向けの救済ルートを足す方法もあります。ベンチマークのAIPerfは、前述のとおりuvでインストールします。実行コマンドの全文は、「ベンチマーク: AgentX MVP」で紹介したとおりです。
まとめ
本記事では、社内で運用しているオンプレミスAIエージェント環境の構成を紹介しました。クライアントからSwitchyardを経由して、オンプレミスのvLLMとClaude APIに振り分ける構成で、ルーティングにはツール履歴のシグナルからターンごとにモデルを選ぶ stage_router を使っています。判定はローカル計算なので、コストも障害リスクも小さく抑えられます。ベンチマークには、ルールが固定された公開ベンチマーク(AgentX MVP)を使うことで、同じ条件での比較と再現を心がけました。コスト試算についても計算過程を示したので、前提を自社の数字に置き換えて試算していただけます。
今回紹介したNeMo Switchyard、AIPerfは、いずれも開発が活発なOSSで、ワークロードに応じて調整しながら運用していくイメージです。マクニカでは、こうした最新のAIソフトウェアの検証を継続的に行っており、本連載の内容もその検証で得た知見に基づいています。そのため、導入前の検証(AI TRY NOW PROGRAM)から、環境の構築、ハイブリッド推論環境の構成やチューニング、本番導入後の運用まで、実際の検証に基づいてサポートできます。ご検討の際は、お気軽にご相談ください。
引用文献
- [1] NVIDIA Technical Blog, “Route AI Agent Workloads Across Models with NVIDIA NeMo Switchyard”
- [2] NVIDIA-NeMo, “Switchyard” (GitHub)
- [3] ai-dynamo, “AIPerf” (GitHub)
- [4] NVIDIA, “InferenceX AgentX MVP Benchmark — NVIDIA AIPerf Documentation”
- [5] SemiAnalysis, “InferenceX by SemiAnalysis — Open-Source Agentic Inference Benchmark”
- [6] ai-dynamo, “InferenceX AgentX MVP — AIPerf Documentation (GitHub)”
- [7] SemiAnalysis, “cc-traces-weka-062126”(Hugging Face データセット、Claude Codeのセッション 393本)
- [8] Anthropic, “Pricing — Claude Platform Docs”
お問い合わせ